

Computer-Use Agents: Bagaimana AI Belajar Mengoperasikan Desktop
(https://www.anthropic.com/news/developing-computer-use)
Bayangkan kamu punya asisten yang bisa membuka aplikasi lama di komputer kantor, mengisi formulir di jendela yang tidak punya API, lalu menyimpan hasilnya tanpa kamu menyentuh mouse. Selama ini AI hanya bisa menjawab lewat kotak chat. Sekarang, sebagian model mulai belajar memakai layar seperti manusia. Pertanyaannya, apa yang sebenarnya dipelajari model ini? Jawabannya bukan sekadar mengetik perintah, melainkan memahami apa yang tampak di layar lalu bertindak berdasarkan itu.
Apa Itu Computer-Use Agent?
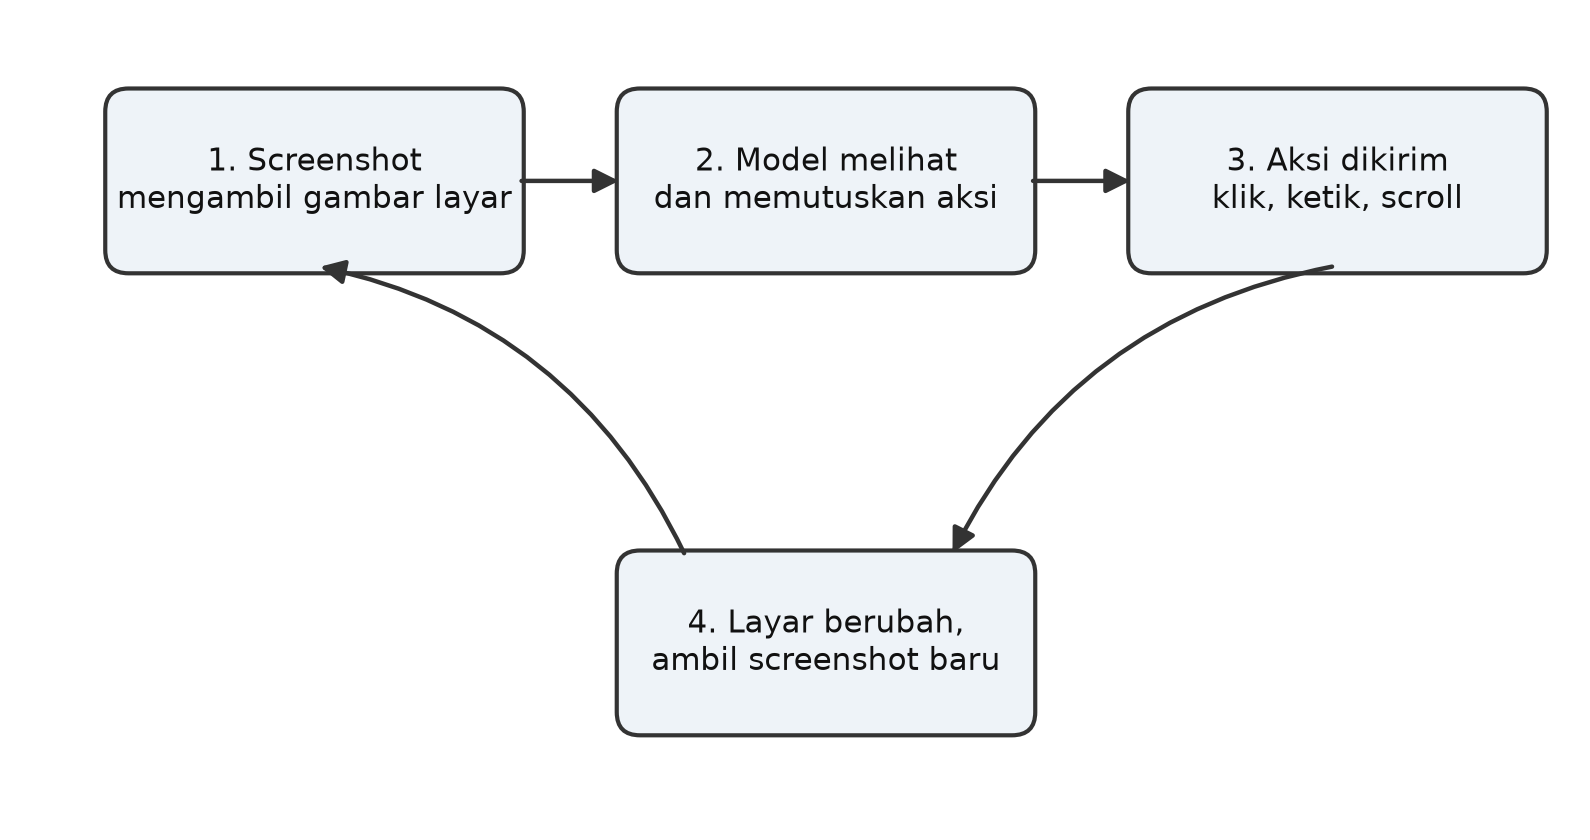
Computer-use agent adalah AI yang bekerja dengan cara melihat layar, lalu mengirim aksi mouse dan keyboard ke sistem operasi. Anggap saja seperti orang yang duduk di depan komputer, tetapi tangannya dikendalikan model bahasa. Anthropic memperkenalkan kemampuan ini pada 2024 lewat Claude 3.5 Sonnet dalam status public beta. OpenAI kemudian menghadirkan Operator, yang didukung model bernama Computer-Using Agent (CUA). Alih-alih bergantung pada integrasi API khusus, agen ini menafsirkan antarmuka yang sedang terbuka. Siklusnya ditunjukkan pada figure 1.
Cara Kerjanya: Melihat, Memutuskan, Lalu Bertindak
- Screenshot: sistem mengambil gambar layar dan mengirimkannya ke model.
- Keputusan: model menentukan langkah berikutnya, misalnya klik tombol atau mengetik teks.
- Aksi: perintah dikirim ke sistem, lalu layar diambil lagi untuk langkah berikutnya.
Bagian tersulitnya ada pada posisi. Menurut Anthropic, model harus menghitung jumlah piksel secara horizontal dan vertikal agar kursor mendarat di tempat yang tepat. Tanpa kemampuan ini, model kesulitan memberi perintah mouse yang akurat. Perubahan ukuran jendela juga dapat menggeser koordinat yang sudah dipilih. Karena itu, agen perlu memeriksa kembali layar setelah aksi penting untuk memastikan antarmuka berubah sesuai dugaan.
Contoh Penggunaan di Dunia Nyata
Skenario pertama adalah mengisi formulir di situs yang belum punya API. OpenAI menyebut Operator dapat mengisi formulir, memesan belanjaan, hingga membuat meme di browser. Skenario kedua adalah pekerjaan berulang di aplikasi desktop lama, seperti menyalin data antarjendela. Skenario ketiga adalah pengujian antarmuka, ketika tim QA ingin mengecek aplikasi persis seperti yang dilihat pengguna. Pola ini berguna ketika integrasi formal belum ada.
Perbandingan Singkat
| Aspek | Computer-use agent | API tradisional |
| Cara berinteraksi | Melihat layar, klik, dan ketik | Memanggil endpoint yang disediakan |
| Integrasi khusus | Tidak selalu dibutuhkan | Wajib dibuat untuk tiap aplikasi |
| Kecepatan | Lambat, banyak langkah | Cepat, sering hanya satu panggilan |
| Saat UI berubah | Bisa beradaptasi, tetapi bisa salah klik | Tetap stabil selama API tidak berubah |
| Pengawasan | Perlu dipantau secara ketat | Mudah diatur lewat hak akses |
| Cocok untuk | Aplikasi tanpa API | Integrasi yang sudah terstruktur |
Kelebihan dan Keterbatasan
(https://arxiv.org/abs/2404.07972)
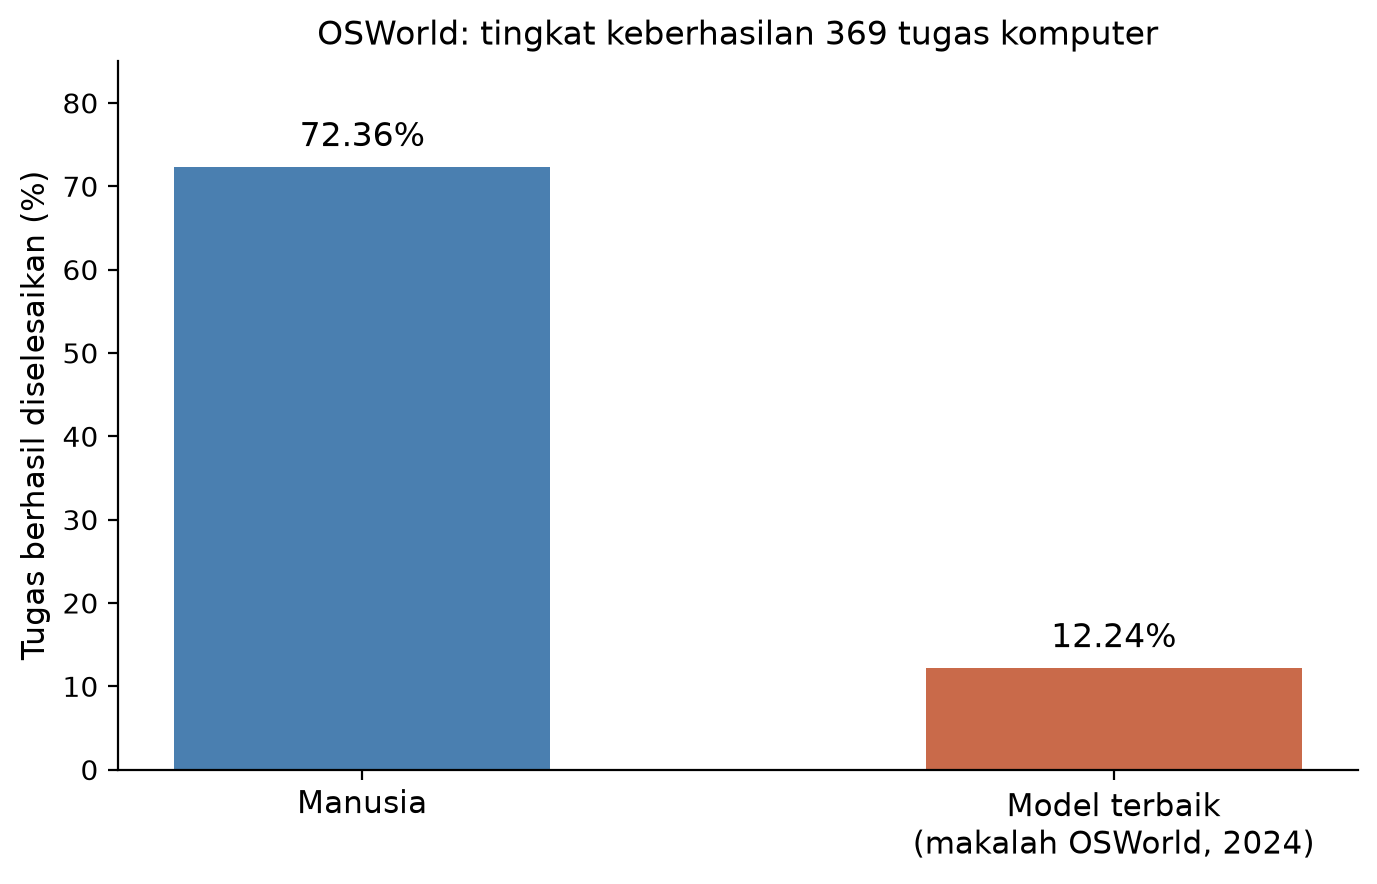
Benchmark OSWorld versi awal berisi 369 tugas di aplikasi web dan desktop nyata. Manusia berhasil menyelesaikan lebih dari 72 persen tugas, sementara model terbaik pada 2024 hanya 12,24 persen (lihat figure 2). Anthropic melaporkan Claude 3.5 Sonnet mencapai 14,9 persen di benchmark yang sama. Pada 2026, OSWorld 2.0 menunjukkan agen masih jauh dari kerja profesional: model terbaik, Claude Opus 4.8, hanya menyelesaikan 20,6 persen tugas secara penuh. Keterbatasan utamanya bisa dibagi menjadi tiga:
- Lambat dan boros langkah: studi OSWorld-Human menemukan latensi bisa mencapai puluhan menit untuk tugas yang manusia selesaikan dalam beberapa menit. Agen terbaik juga mengambil 2,7 sampai 4,3 kali lebih banyak langkah dari yang diperlukan.
- Mudah salah membaca layar: Anthropic mengakui kemampuan ini masih sering keliru. Karena model melihat layar lewat tangkapan terpisah, bukan video, ia bisa melewatkan aksi singkat atau notifikasi.
- Rentan prompt injection: teks jahat di halaman web bisa membelokkan agen dari tujuan awal. OpenAI merancang Operator untuk mengabaikan instruksi semacam itu, tetapi mengakui tidak ada sistem yang sepenuhnya kebal.
Karena itu, Operator dilatih untuk meminta pengguna mengambil alih saat login, pembayaran, atau CAPTCHA muncul. Mekanisme ini menunjukkan AI belum layak bekerja sendirian pada hal sensitif. Pengguna sebaiknya meninjau hasil sebelum membiarkan agen melanjutkan ke langkah berikutnya. Hak akses juga perlu dibatasi sesuai tugas. Dengan begitu, manusia tetap memegang kendali ketika tindakan berisiko muncul.
Kesimpulan
Computer-use agent membuka jalan bagi AI untuk bekerja di aplikasi yang belum punya API. Namun, reliabilitasnya masih jauh di bawah manusia, sehingga untuk saat ini sebaiknya dipakai dengan pengawasan dan izin yang jelas. Sebelum memberi AI akses ke layarmu, tanyakan dulu: apa yang terjadi jika ia salah klik? Peningkatan benchmark saja belum cukup; sistem juga perlu menunjukkan kendali yang dapat dipahami pengguna. Untuk pekerjaan sehari-hari, mulailah dari tugas berisiko rendah dan periksa hasilnya.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Anthropic. (2024). Developing a computer use model. https://www.anthropic.com/news/developing-computer-use
OpenAI. (2025). Introducing Operator. https://openai.com/index/introducing-operator/
Xie dkk. (2024). OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. https://arxiv.org/abs/2404.07972
arXiv. (2025). OSWorld-Human: Benchmarking the Efficiency of Computer-Use Agents. https://arxiv.org/abs/2506.16042
OSWorld Team. (2026). OSWorld 2.0: Benchmarking Computer-Use Agents on Long-Horizon Real-World Tasks. https://osworld-v2.xlang.ai/
Comments :