

LLM Routing: Mengapa Satu Aplikasi AI Bisa Membutuhkan Banyak Model?
(https://www.lmsys.org/blog/2024-07-01-routellm/)
Pernahkah kamu memesan truk kontainer besar hanya untuk mengantar sebuah amplop surat? Pilihan itu tentu boros bahan bakar dan mahal. Ironisnya, pemborosan semacam ini kerap terjadi saat developer memaksakan satu model frontier raksasa untuk menangani seluruh kueri pengguna. Kenyataannya, tidak semua interaksi memerlukan komputasi tingkat tinggi. Kueri ringan seperti sapaan atau ekstraksi teks cukup dijawab model kecil yang hemat dan cepat. Sebaliknya, penalaran hukum atau kalkulasi rumit tetap membutuhkan model flagship. Kebutuhan menyeimbangkan biaya, latensi, dan akurasi inilah yang melahirkan LLM routing.
Apa Itu LLM Routing?
LLM routing adalah lapisan perantara cerdas yang menganalisis prompt masuk dan mengarahkannya ke model bahasa yang paling sesuai secara dinamis. Konsep perutean ini mulai mencuri perhatian saat Chen, Zaharia, dan Zou dari Universitas Stanford memperkenalkan kerangka kerja FrugalGPT pada tahun 2023. Riset tersebut menunjukkan bahwa mengombinasikan beberapa model mampu memangkas biaya inferensi hingga 98% dalam eksperimen mereka dengan akurasi setara model terbaik. Evolusi sistem perutean berlanjut pada tahun 2024 lewat riset RouteLLM oleh Ong dkk. bersama tim LMSYS Org. Daripada bergantung pada satu model mahal, sistem routing menempatkan pengklasifikasi ringan di depan sekumpulan model. Komponen ini membaca maksud kueri, lalu menentukan apakah kueri cukup dikirim ke model hemat atau harus dialihkan ke model bernalar tinggi.
Bagaimana LLM Routing Bekerja?
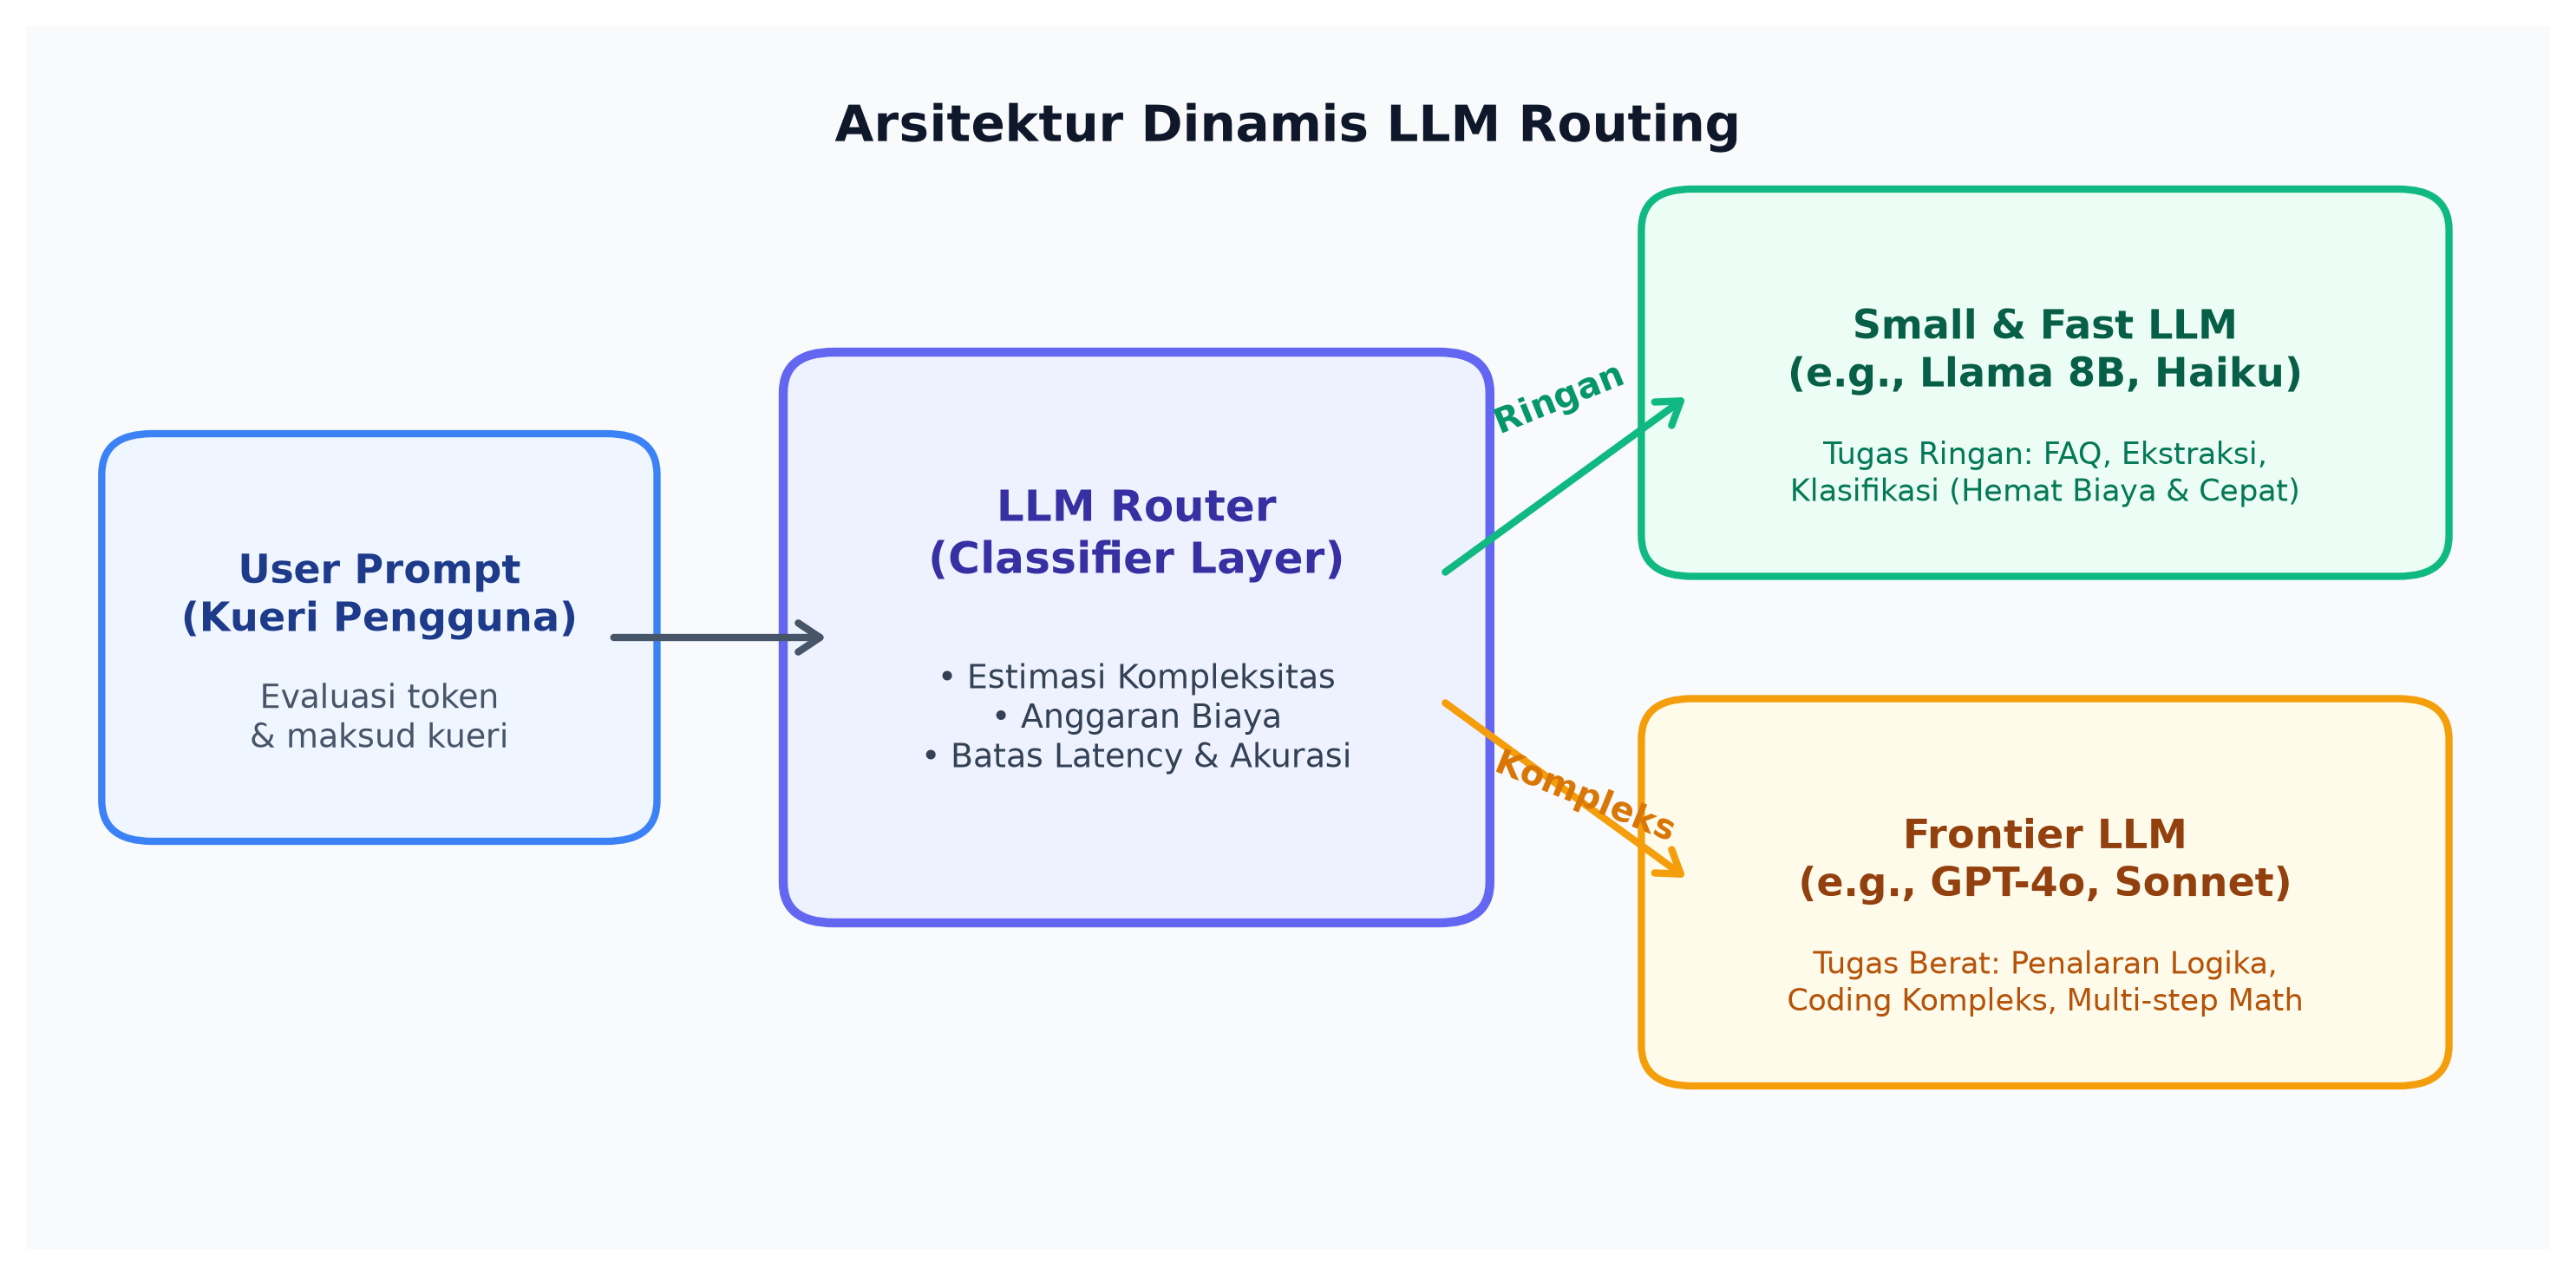
Seperti terlihat pada figure 1, sistem perutean bekerja secara langsung sebelum kueri diteruskan ke model tujuan. Lapisan ini berfungsi sebagai pengambil keputusan, bukan pengganti model yang menjawab. Kualitas pilihan bergantung pada konteks aplikasi dan kebutuhan pengguna. Keputusan tersebut perlu menyeimbangkan mutu jawaban dengan sumber daya yang tersedia. Router mengevaluasi permintaan berdasarkan empat pertimbangan penting:
- Kompleksitas Task: Menilai tingkat kesulitan penalaran instruksi pengguna.
- Anggaran Latency: Memilih model berkecepatan tinggi jika aplikasi butuh respons kilat.
- Biaya Inferensi: Menekan pengeluaran token pada tugas rutin yang repetitif.
- Kebutuhan Akurasi: Mengarahkan kueri bernilai tinggi ke model terkuat demi menjaga ketepatan jawaban.
Penerapan LLM Routing di Industri Nyata
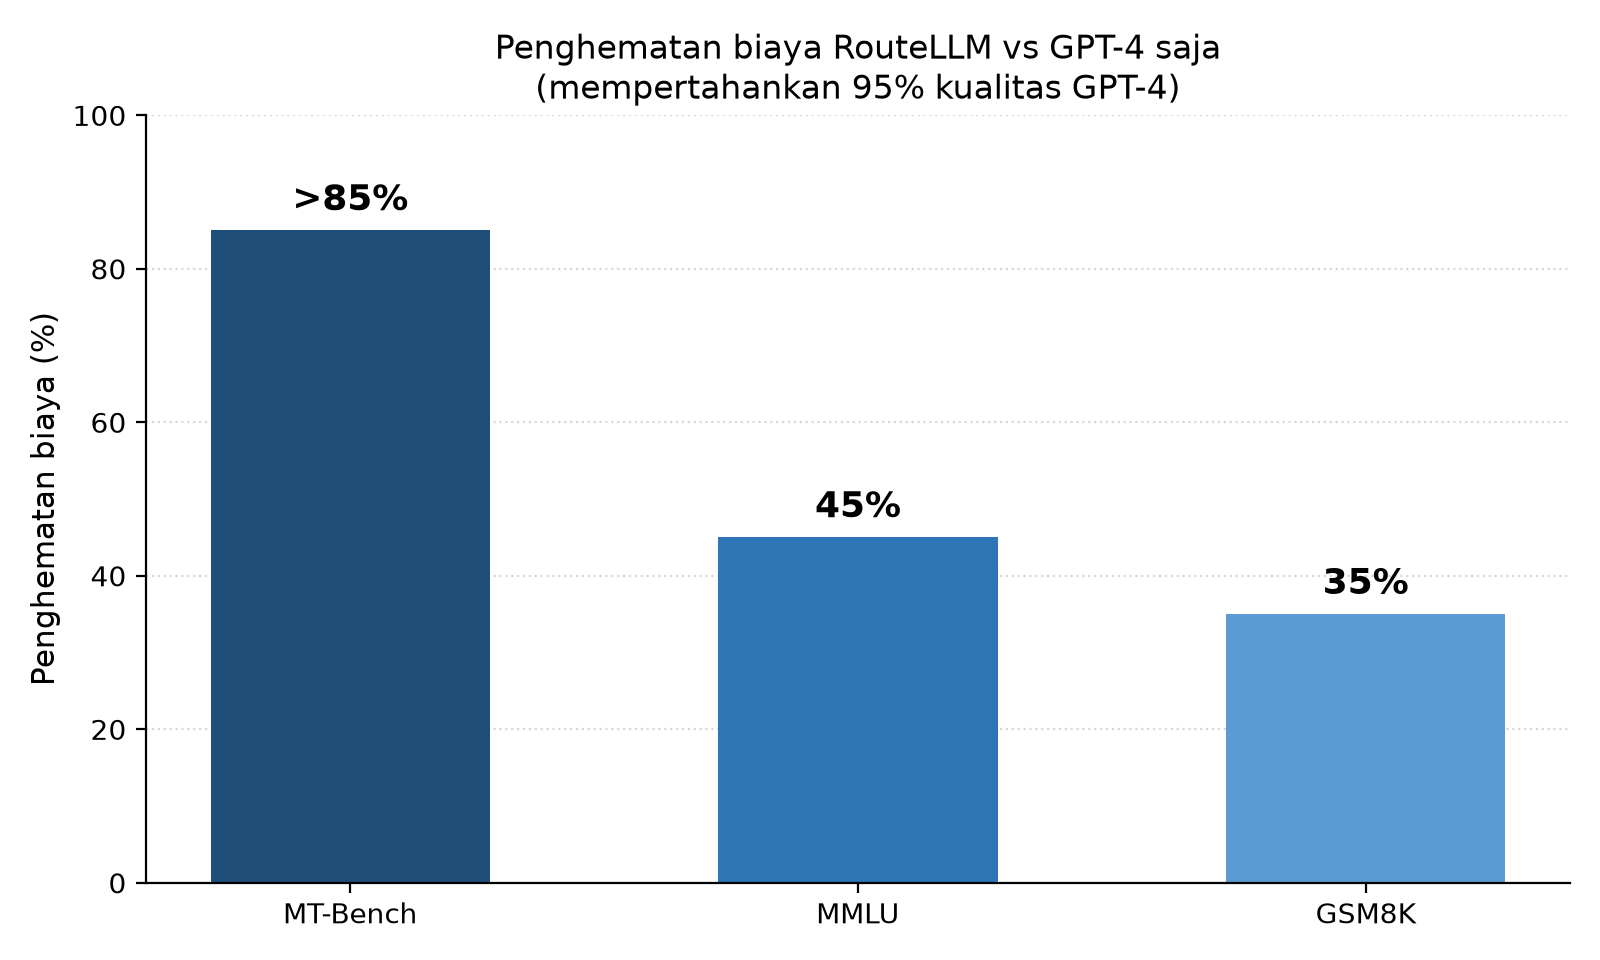
Implementasi perutean kini menjadi fondasi operasional berbagai penyedia komputasi awan. Amazon Web Services meluncurkan Amazon Bedrock Intelligent Prompt Routing dalam pratinjau pada 2024, dengan klaim penghematan biaya hingga 30% tanpa mengorbankan akurasi. Dokumentasi resminya kini menampilkan model Amazon Nova dan Meta Llama sebagai model yang didukung routing untuk satu keluarga model. Penyedia infrastruktur Cloudflare juga menghadirkan Dynamic Routing di AI Gateway, yang memilih model berdasarkan kondisi, membagi trafik secara persentase, dan beralih ke model cadangan saat batas anggaran atau kuota terlampaui. Sementara itu, riset RouteLLM oleh LMSYS Org mencatat penghematan biaya lebih dari 85% pada MT-Bench, 45% pada MMLU, dan 35% pada GSM8K dibanding memakai GPT-4 saja, dengan tetap mempertahankan 95% kualitas GPT-4. Figure 2 merangkum angka tersebut dalam bentuk grafik.
(https://www.lmsys.org/blog/2024-07-01-routellm/)
Perbandingan Pendekatan Pemilihan Model
| Aspek Evaluasi | Model Tunggal Besar | Model Tunggal Kecil | Arsitektur LLM Routing |
| Biaya Inferensi | Mahal dan boros | Murah dan hemat | Optimal sesuai kebutuhan |
| Rata-rata Latency | Cenderung lambat | Cepat | Cepat dan seimbang |
| Akurasi Tugas Rumit | Tinggi | Rentan keliru | Tetap terjaga tinggi |
| Kompleksitas Sistem | Sederhana tanpa router | Sederhana tanpa router | Memerlukan layer router |
Kelebihan dan Tantangan Penerapan
Adopsi multi-model memberikan efisiensi anggaran nyata bagi aplikasi skala besar. Sistem menjadi lebih tangguh karena tidak terkunci pada satu vendor, serta terlindung oleh rute cadangan saat penyedia utama mengalami gangguan. Tantangannya, layer pengklasifikasi menambah sedikit latensi ekstra sebelum kueri dieksekusi. Tim pengembang juga harus memperbarui aturan routing seiring rilisnya model-model baru di pasar. Pengujian berkala membantu memastikan pilihan router tetap sesuai dengan pola kueri yang digunakan.
Kesimpulan
Model kecerdasan buatan terbesar bukanlah solusi terbaik untuk setiap skenario komputasi. Ke depan, keunggulan aplikasi AI ditentukan oleh kecakapan mengorkestrasi berbagai model secara terpadu. Melalui penerapan LLM routing, kita dapat menghadirkan aplikasi yang berkinerja tinggi, hemat biaya, dan siap berkembang di dunia nyata. Pemilihan model yang tepat membuat setiap kueri memakai kapasitas yang memang dibutuhkannya. Karena itu, manfaat routing paling terasa ketika efisiensi tetap diimbangi evaluasi kualitas jawaban.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Amazon Web Services. (2024). Reduce costs and latency with Amazon Bedrock Intelligent Prompt Routing and prompt caching (preview). https://aws.amazon.com/cn/blogs/aws/reduce-costs-and-latency-with-amazon-bedrock-intelligent-prompt-routing-and-prompt-caching-preview/
Amazon Web Services. (2026). Understanding intelligent prompt routing in Amazon Bedrock. https://docs.aws.amazon.com/bedrock/latest/userguide/prompt-routing.html
Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. https://arxiv.org/abs/2305.05176
Cloudflare. (2026). Dynamic routing. https://developers.cloudflare.com/ai-gateway/features/dynamic-routing/
LMSYS Org. (2024). RouteLLM: An Open-Source Framework for Cost-Effective LLM Routing. https://www.lmsys.org/blog/2024-07-01-routellm/
Ong, I., Almahairi, A., Wu, V., Chiang, W. L., Wu, T., Gonzalez, J. E., Kadous, M. W., & Stoica, I. (2024). RouteLLM: Learning to Route LLMs with Preference Data. https://arxiv.org/abs/2406.18665
Comments :