

Tool Calling LLM: Bagaimana AI Menjalankan Fungsi di Luar Chat
(https://docs.anthropic.com/en/docs/build-with-claude/tool-use)
Pernahkah kamu meminta model bahasa memeriksa status pesanan belanjaan atau menghitung kurs valuta asing, lalu memperoleh jawaban yang akurat? Di balik kemampuan itu, model bahasa tidak memiliki kalkulator bawaan ataupun akses langsung ke sistem luar. Tanpa integrasi khusus, model murni hanyalah pemrediksi kata yang terkunci pada memori data latihnya. Keterbatasan inilah yang dijembatani oleh tool calling. Mekanisme ini mengubah model bahasa dari sekadar penghasil teks menjadi agen komputasi yang mampu berinteraksi dengan API eksternal dan mengolah data dinamis dunia nyata.
Mengenal Konsep Tool Calling pada LLM
Secara sederhana, tool calling adalah kemampuan model bahasa mendeteksi kebutuhan alat luar, memilih fungsi yang cocok, dan menyusun instruksi terstruktur untuk mengeksekusinya. Konsep ini diperkenalkan oleh Timo Schick dan para peneliti Meta AI pada Februari 2023 lewat publikasi Toolformer, yang menunjukkan bahwa model dapat diajari memanggil API secara mandiri. Perkembangan ini berlanjut saat OpenAI merilis function calling pada Juni 2023. Kini Anthropic juga menghadirkan mekanisme serupa pada Claude. Penting untuk membedakan permintaan tool dari eksekusi fungsi: model memilih dan menyusun parameter, sedangkan aplikasi yang menjalankannya.
Siklus Kerja dan Alur Eksekusi Fungsi
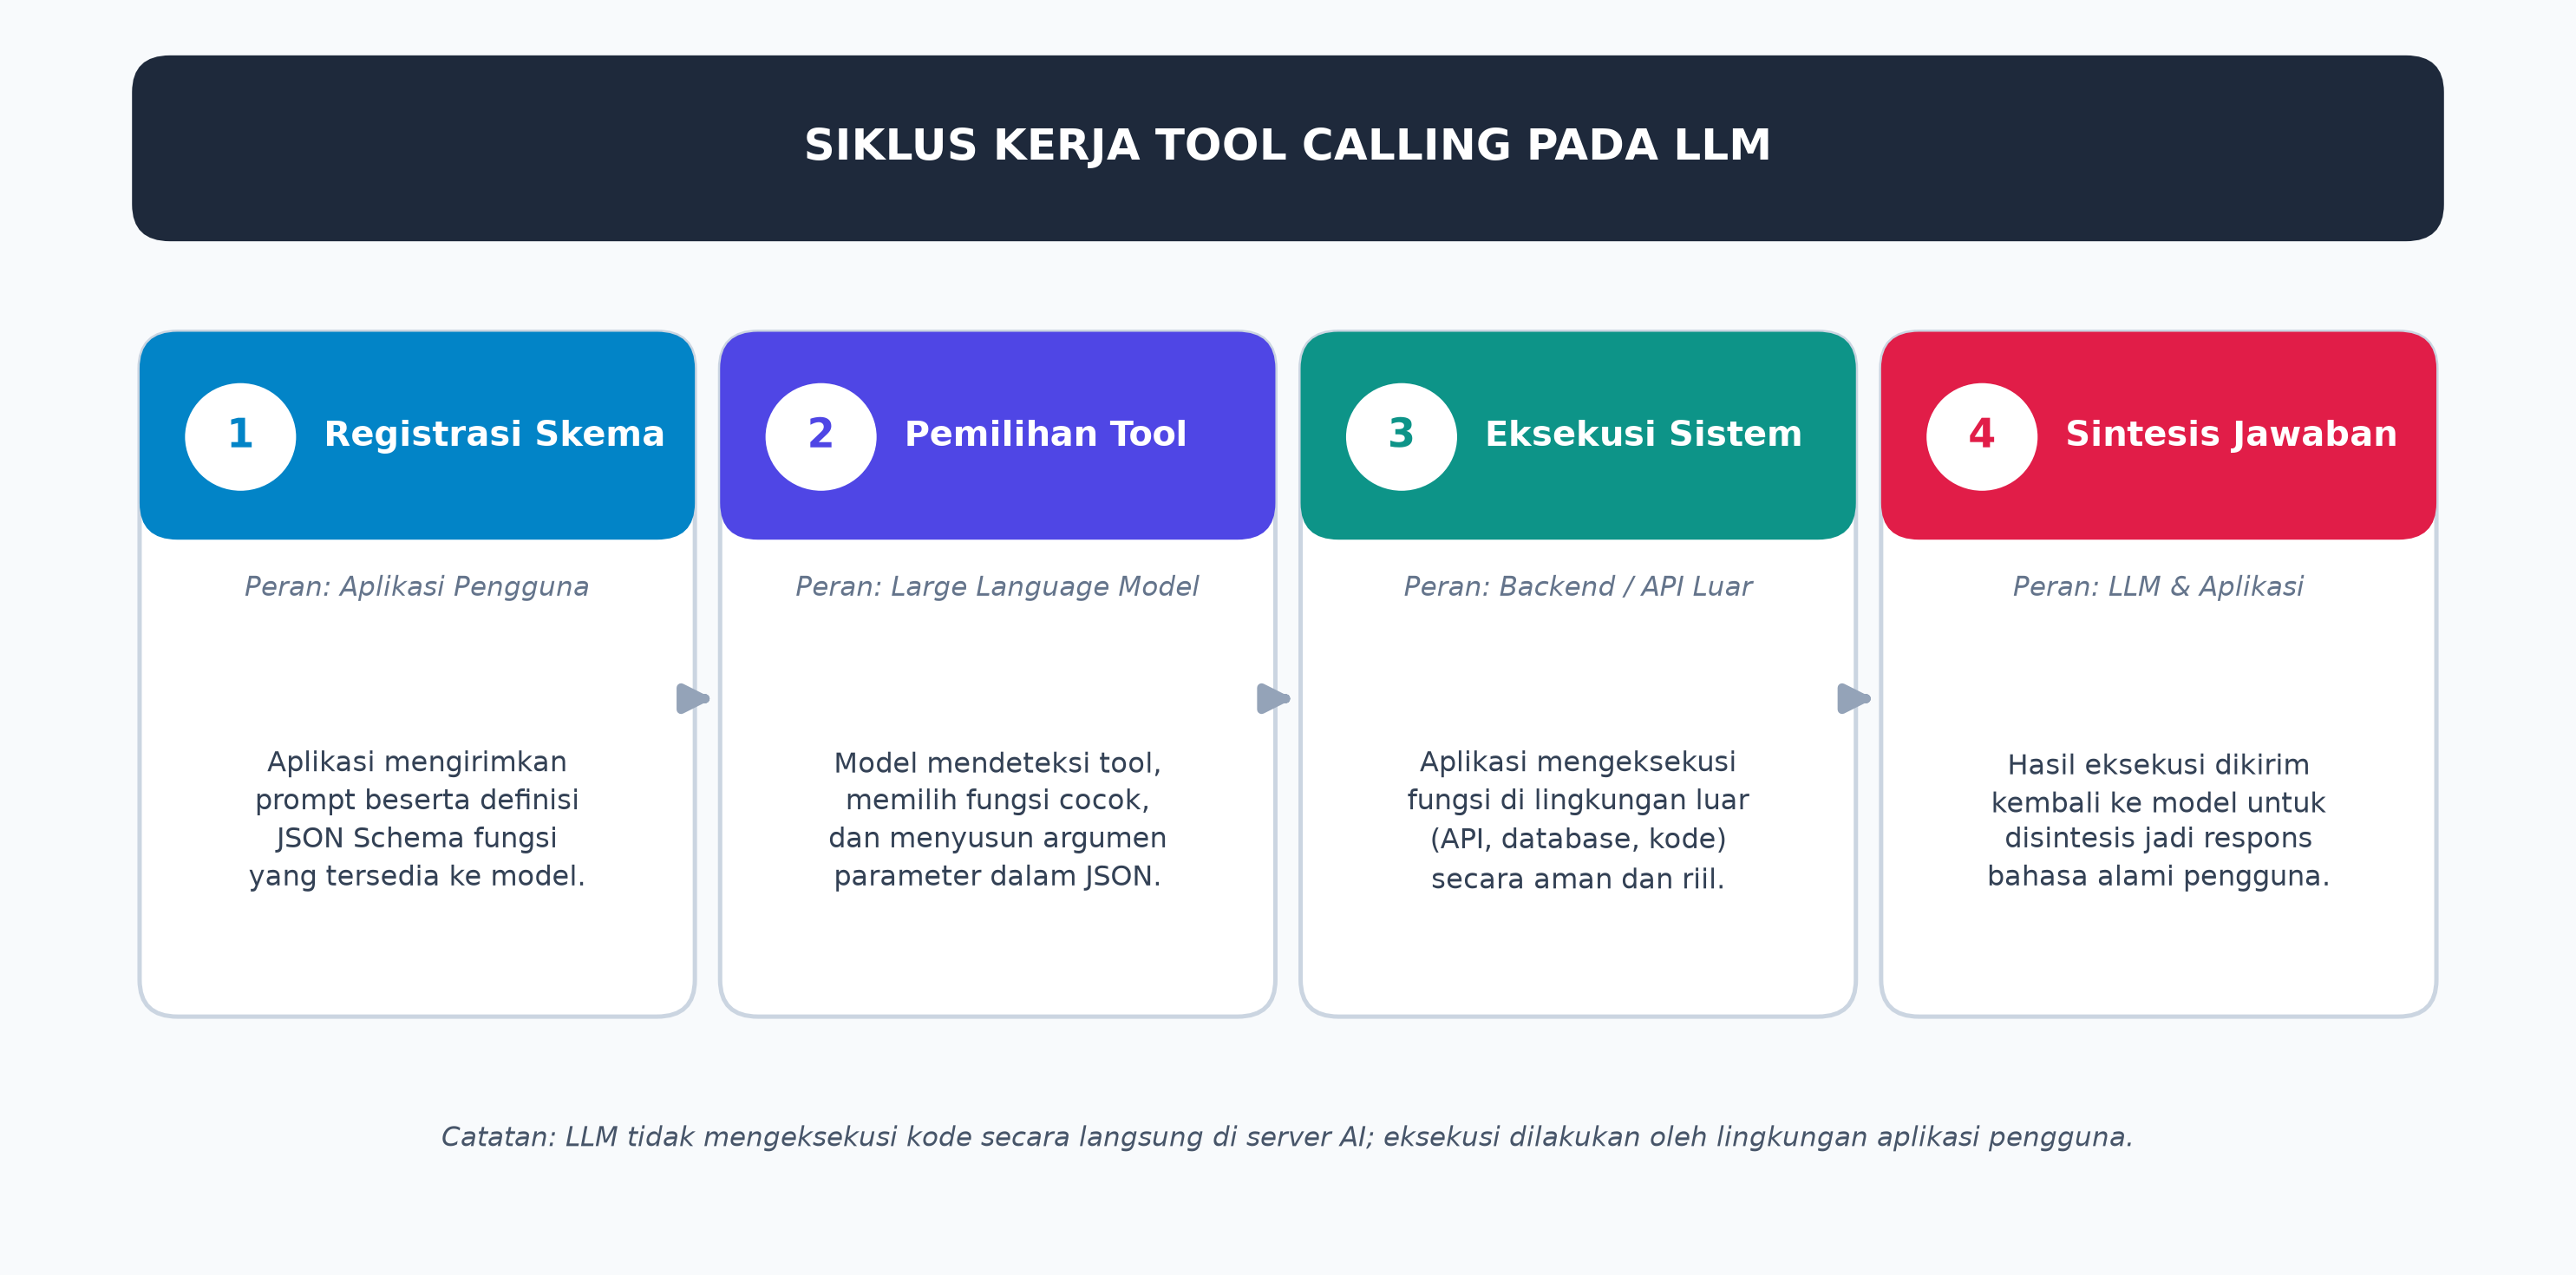
Banyak orang mengira model bahasa mengeksekusi kode langsung di server AI. Faktanya, model hanya bertindak sebagai orkestrator yang memetakan kebutuhan pengguna ke parameter teknis melalui empat tahapan pada figure 1. Aplikasi menghubungkan model dengan fungsi yang tersedia. Pilihan alat dan argumennya dikirim ke aplikasi. Setelah sistem memperoleh hasil, percakapan berlanjut dengan konteks baru:
- Registrasi skema fungsi: aplikasi menyertakan spesifikasi alat berupa skema parameter terstruktur bersama prompt pengguna, memuat nama dan deskripsi fungsi.
- Pemilihan tool dan pembuatan parameter: model mengenali kebutuhan konteks, memilih fungsi yang tepat, lalu menyusun muatan data JSON berisi argumen pemanggilan.
- Eksekusi mandiri pada sistem: aplikasi klien menerima keluaran JSON tersebut dan menjalankan fungsi pada sistem atau API lokal.
- Sintesis jawaban akhir: luaran fungsi dikirim kembali ke model untuk dirangkai menjadi bahasa alami yang mudah dipahami pengguna.
(https://gorilla.cs.berkeley.edu/blogs/8_berkeley_function_calling_leaderboard.html)
Contoh Penerapan di Dunia Nyata
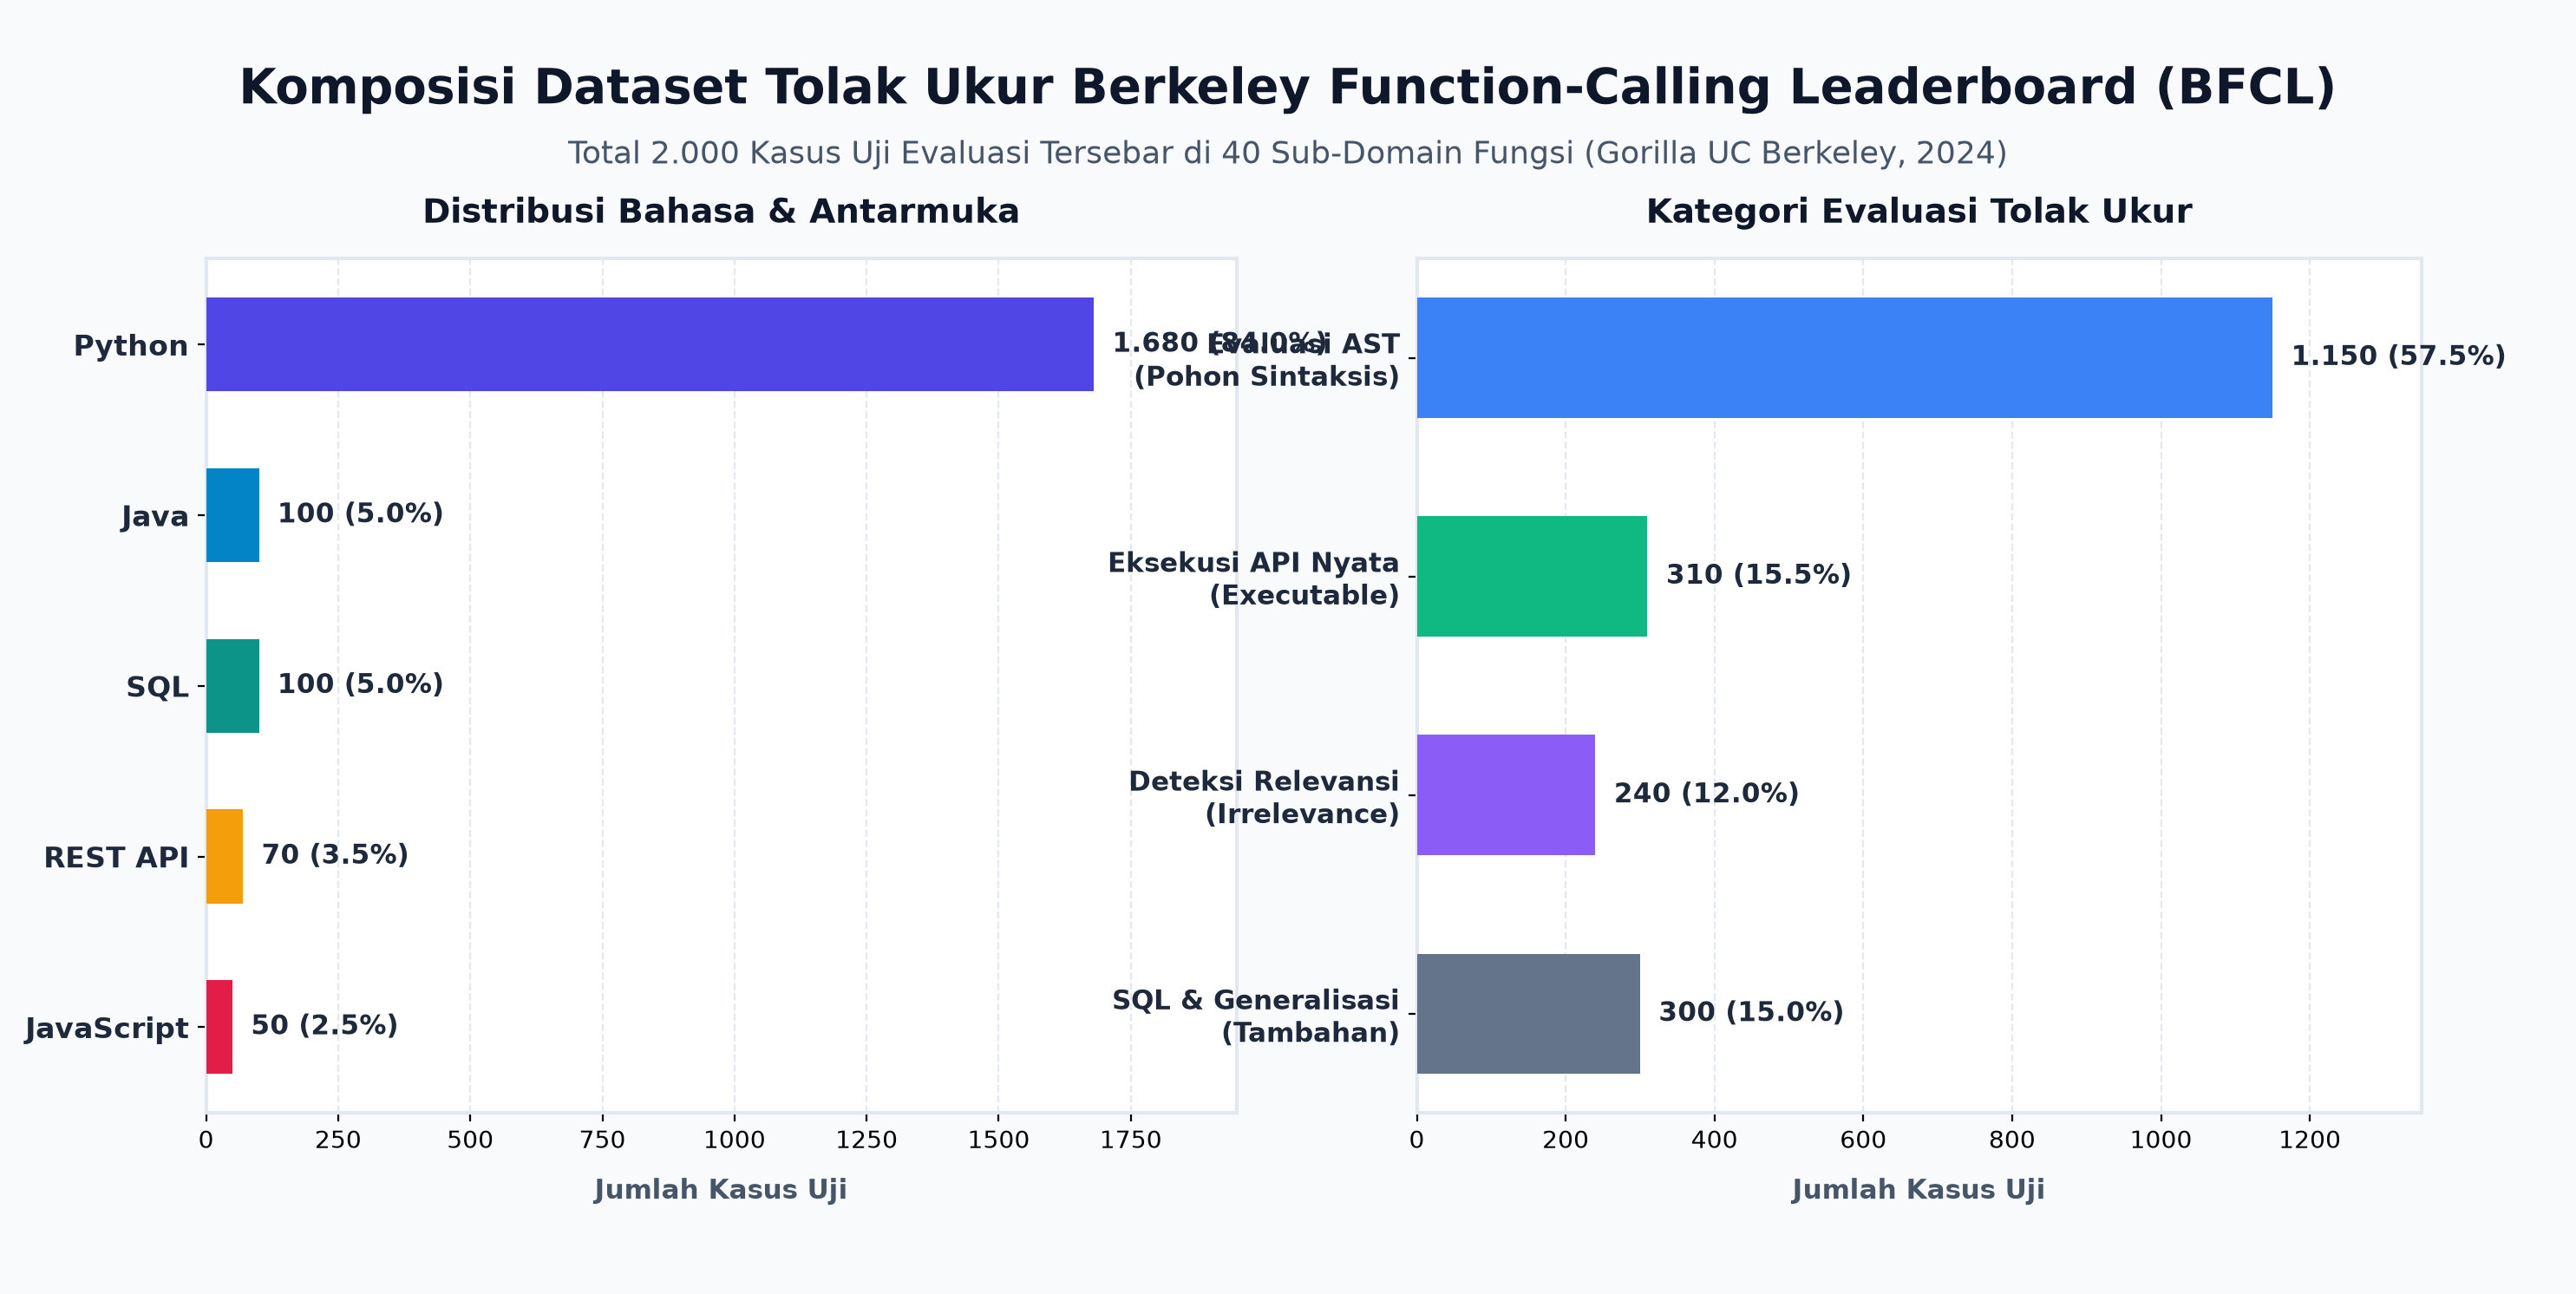
Penerapan tool calling mencakup beragam skenario praktis. Bayangkan aplikasi belanja daring yang memeriksa resi pengiriman lewat REST API ekspedisi. Contoh lain adalah aplikasi perbankan hipotetis yang memanggil kalkulator keuangan terprogram guna menghitung simulasi pinjaman, sehingga terhindar dari risiko halusinasi angka. Kemampuan eksekusi ini dievaluasi secara ketat oleh tim peneliti Gorilla dari UC Berkeley sejak 2024. Versi awal tolak ukur Berkeley Function-Calling Leaderboard (BFCL) menguji model pada 2.000 kasus uji di 40 sub-domain fungsi untuk memastikan ketepatan pemilihan alat dan penolakan fungsi yang tidak relevan. Kini BFCL V4 berfokus pada evaluasi agentik, dengan komposisi bahasa dataset yang ditunjukkan pada figure 2.
Perbandingan Chat Konvensional dan Tool Calling
| Aspek | Chat LLM Konvensional | LLM dengan Tool Calling |
| Sumber Data | Bobot data latih statis | Data terkini dari API eksternal |
| Akurasi Hitung | Rentan halusinasi angka | Presisi tinggi lewat eksekusi kode |
| Kapabilitas Aksi | Pasif menghasilkan teks | Aktif memicu tindakan sistem |
| Kendali Eksekusi | Berjalan di server penyedia model | Berada di kendali aplikasi klien |
| Format Antara | Teks bebas tanpa skema | Objek JSON terstruktur |
Keunggulan dan Tantangan Operasional
Keunggulan utama arsitektur ini adalah akurasi data dan kendali keamanan. Karena fungsi dijalankan di aplikasi pengguna, pengembang leluasa membatasi wewenang eksekusi sebelum perintah diproses. Pengembang juga dapat memisahkan izin dari kemampuan model, sehingga model tidak otomatis menjalankan semua fungsi. Kendati demikian, tantangan teknis tetap hadir. Komunikasi jaringan bolak-balik menambah latensi respons. Sistem juga rentan manipulasi instruksi (indirect prompt injection) lewat data API luar, serta potensi kegagalan pembacaan format JSON saat memanggil banyak fungsi sekaligus. Karena itu, setiap hasil tool perlu divalidasi sebelum dipakai untuk tindakan lanjutan. Fungsi berisiko tinggi sebaiknya meminta persetujuan manusia.
Kesimpulan
Mekanisme tool calling memperluas fungsi model bahasa dari teman mengobrol menjadi agen komputasi praktis. Pembagian peran antara penalaran model dan eksekusi sistem membuat interaksi lebih terukur. Efektivitasnya bertumpu pada skema fungsi yang dirancang disiplin. Integrasi alat perlu disesuaikan dengan risiko tindakannya. Batas izin dan pemeriksaan menjaga kendali manusia.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Anthropic. (2024). Tool Use with Claude. https://docs.anthropic.com/en/docs/build-with-claude/tool-use
OpenAI. (2023). Function Calling and Other API Updates. https://openai.com/index/function-calling-and-other-api-updates/
Patil, S. G., Mao, H., Cheng-Jie Ji, C., Yan, F., Suresh, V., Stoica, I., & Gonzalez, J. E. (2025). The Berkeley Function Calling Leaderboard (BFCL): From Tool Use to Agentic Evaluation of Large Language Models. https://gorilla.cs.berkeley.edu/leaderboard.html
Schick, T., Dwivedi-Yu, J., Dessì, R., Raileanu, R., Lomeli, M., Zettlemoyer, L., Cancedda, N., & Scialom, T. (2023). Toolformer: Language Models Can Teach Themselves to Use Tools. https://arxiv.org/abs/2302.04761
Yan, F., Mao, H., Ji, C. C., Stoica, I., Gonzalez, J. E., Zhang, T., & Patil, S. G. (2024). Berkeley Function-Calling Leaderboard. https://gorilla.cs.berkeley.edu/blogs/8_berkeley_function_calling_leaderboard.html
Comments :