

Streaming AI: Mengapa Jawaban Chatbot Muncul Sedikit demi Sedikit?
(https://developers.openai.com/api/docs/guides/streaming-responses)
Pernahkah kamu mengamati jawaban ChatGPT? Ia langsung mengetik kata demi kata, seperti sedang berpikir di layar. Total waktu untuk menuntaskan jawaban tetap sama saja. Keajaibannya ada di perasaanmu: begitu huruf pertama muncul, otak menyimpulkan sistem sudah merespons, dan menunggu terasa lebih singkat. Namanya streaming, dipakai UI ChatGPT, Claude, sampai Gemini, dan kini jadi standar bawaan API model bahasa besar.
Apa Itu Streaming AI?
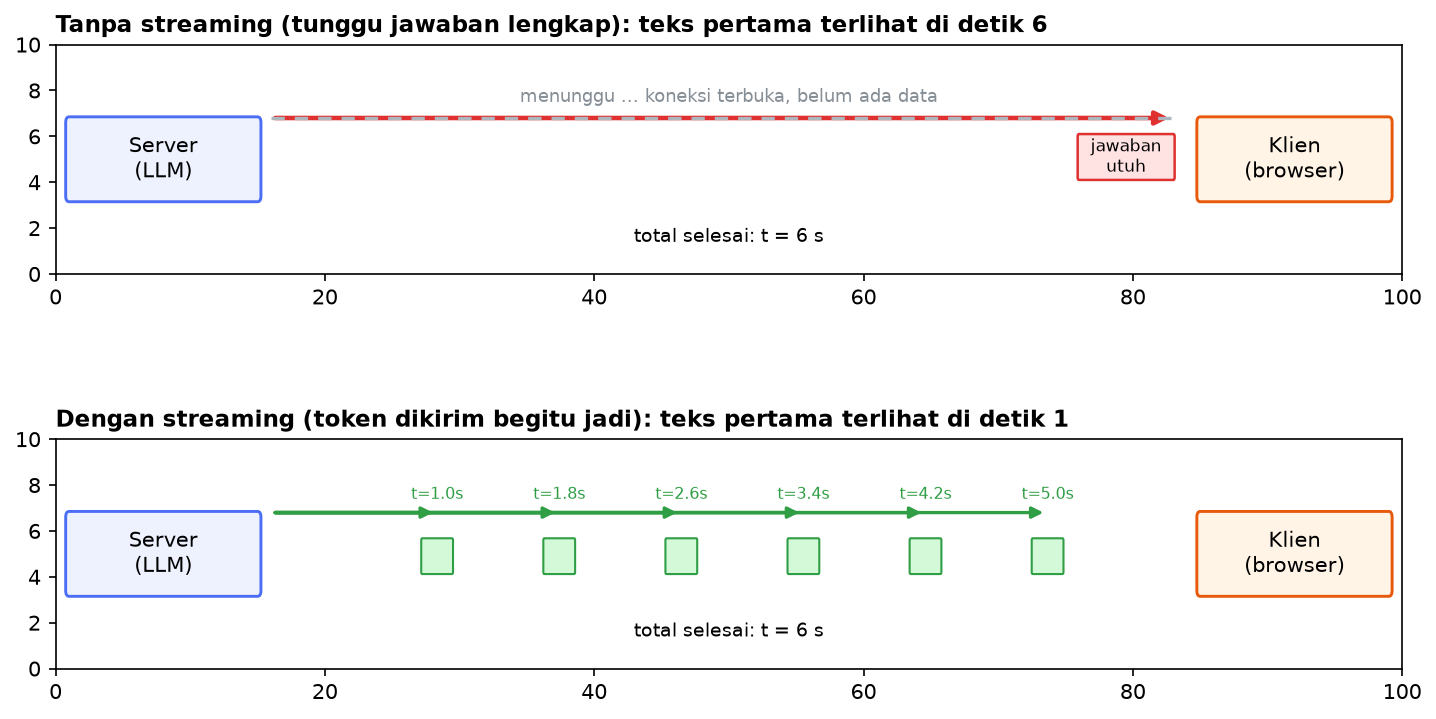
Streaming AI adalah cara mengirim jawaban model secara bertahap: tiap potongan teks langsung diteruskan ke layar begitu jadi, tanpa menunggu jawaban rampung, seperti alur kiri pada Figure 1. Konsepnya menempel pada cara kerja LLM itu sendiri. Hugging Face menjelaskan bahwa model bahasa besar dilatih untuk memprediksi token berikutnya (potongan kata sekitar tiga perempat kata) dari prompt ditambah keluarannya sendiri. Sifat yang disebut autoregressive ini membuat jawaban memang lahir satu token demi satu token; infrastruktur jaringan cukup meneruskan tiap potongan tanpa menunggu yang lain. Dokumentasi OpenAI merangkum bedanya: default API menunggu seluruh output jadi dulu, baru dikirim dalam satu respons HTTP, sedangkan streaming membiarkanmu membaca bagian awal saat sisanya dibuat.
Cara Kerja Streaming pada API LLM
- Token streaming: model menghasilkan token berurutan, dan server meneruskan tiap token begitu lahir. Di Anthropic, potongan tiba sebagai event `content_block_delta` berisi `text_delta` yang ditumpuk sampai utuh.
- Server-Sent Events (SSE): transport favorit streaming LLM. Menurut MDN, SSE adalah koneksi satu arah dari server ke browser di atas HTTP biasa dengan format `text/event-stream`, lengkap dengan reconnect otomatis; sisi klien cukup memakai `EventSource`.
- WebSockets: jalur dua arah dengan protokol sendiri, distandardkan IETF tahun 2011 lewat RFC 6455. Lebih berat karena butuh handshake khusus, dan dipilih saat klien juga mengirim data terus-menerus.
Time-to-First-Token: Latensi yang Terasa
(https://www.nngroup.com/articles/response-times-3-important-limits/)
(https://commons.wikimedia.org/wiki/File:Forever_frame_diagram.png)

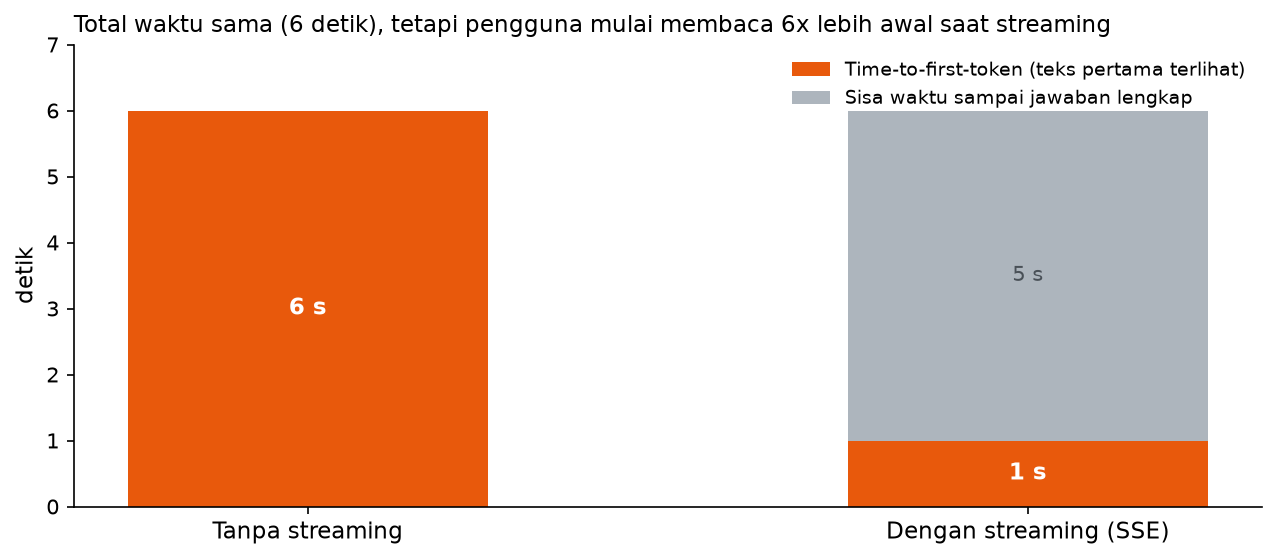
Di sinilah konsep UX penting: time-to-first-token, jarak antara menekan Enter dan huruf pertama tampil, berbeda dari total waktu jawaban selesai; Figure 2 menggambarkan betapa awalnya token pertama tiba. Tim Nielsen Norman Group memetakan tiga batas respons manusia: 0,1 detik agar sistem terasa bereaksi seketika, 1 detik agar alur pikir tetap tersambung, dan 10 detik sebelum perhatian lepas. Streaming memangkas dua batas pertama tanpa mempercepat model. Chat customer service menampilkan balasan template lebih dulu sambil menunggu jawaban lengkap, dan GitHub Copilot mengalirkan saran kode per potongan. Perbedaannya terasa di pertanyaan panjang yang jawabannya butuh belasan detik.
Perbandingan Tiga Pola Pengiriman Data
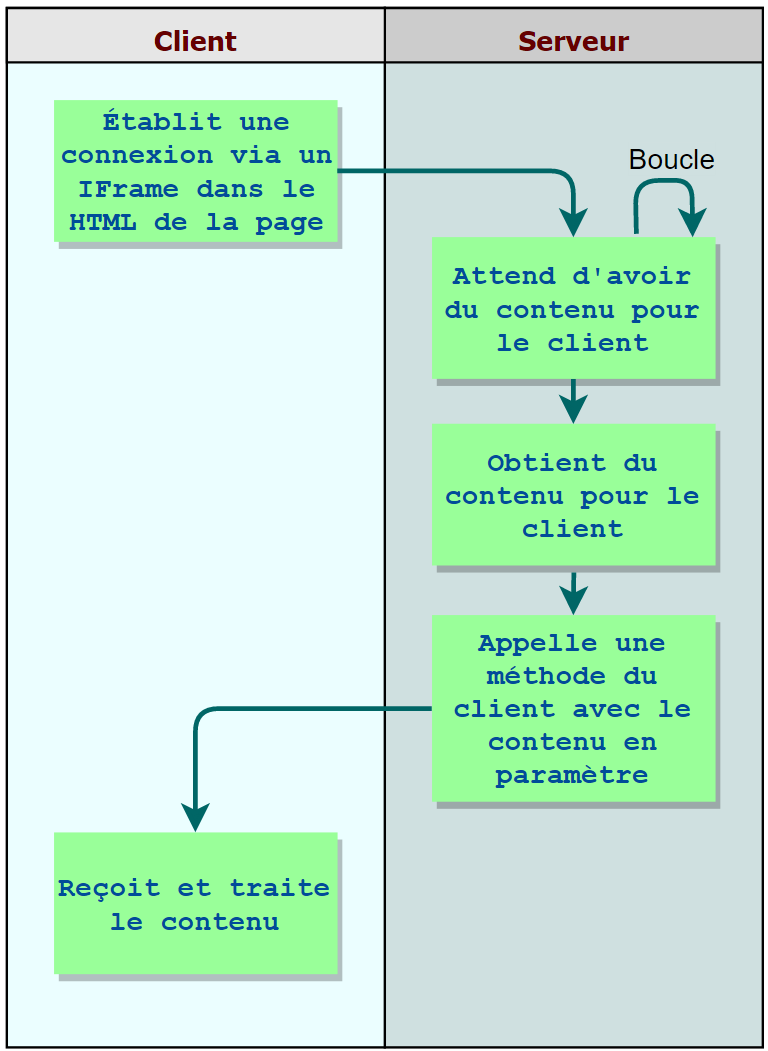
Tiga pola berikut kerap dipakai untuk mengalirkan data dari server ke browser, dan pola komunikasinya tergambar pada Figure 3:
| Aspek | Polling | SSE | WebSocket |
| Arah komunikasi | Klien bertanya, server menjawab | Satu arah, server ke klien | Dua arah, penuh |
| Protokol dasar | HTTP biasa, berulang | HTTP biasa, satu koneksi panjang | Protokol sendiri di atas TCP |
| Overhead tiap update | Tinggi, header ulang tiap permintaan | Rendah, potongan teks kecil | Rendah, tapi koneksi harus dijaga |
| Reconnect otomatis | Tidak perlu, tiap permintaan baru | Ada, bawaan browser | Tidak ada, ditulis sendiri |
| Kompleksitas server | Rendah | Rendah sampai sedang | Lebih tinggi, handshake khusus |
| Cocok untuk chat AI | Kurang, jawaban terasa patah-patah | Cocok, standar de facto LLM | Dipakai kalau klien kirim data terus |
Kelebihan dan Keterbatasan
Kelebihan: pengguna membaca dari detik-detik awal, dan aplikasi bisa memangkas pembicaraan lebih awal kalau jawaban menyimpang. Keterbatasan: jawaban yang belum selesai bisa berubah, dan konten parsial menyulitkan moderasi, catatan yang juga muncul di dokumentasi OpenAI. MDN menambahkan catatan teknisnya: tanpa HTTP/2, jumlah koneksi SSE per domain dibatasi 6 koneksi per browser, dan koneksi WebSocket yang terputus harus disambung ulang oleh aplikasi sendiri. Banyak produk justru menggabungkan: polling untuk status ringan, SSE untuk chat. Pilihannya kembali ke arah data yang bergerak dan kontrol yang dibutuhkan aplikasi.
Kesimpulan
Streaming tidak membuat model berpikir lebih cepat, tetapi menyusun ulang waktu agar pengguna lebih awal dilayani. Total token yang dibuat sama; yang berubah hanyalah kapan tiap token sampai ke mata kamu. Kebiasaan membaca jawaban yang berjalan ini pelan-pelan jadi ekspektasi bawaan aplikasi AI. Ke depan, pola yang sama kemungkinan menyebar ke gambar dan audio yang ditampilkan selagi dirender. Di balik kesan magisnya, mekanisme ini bertumpu pada cara LLM menghasilkan token, SSE yang mengalirkannya, dan desain UX yang menghargai waktu tunggu.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Nielsen Norman Group. (1993). Response Times: The 3 Important Limits. https://www.nngroup.com/articles/response-times-3-important-limits/
Hugging Face. (2025). Text generation. https://huggingface.co/docs/transformers/llm_tutorial
OpenAI. (2025). Streaming API responses. https://developers.openai.com/api/docs/guides/streaming-responses
Anthropic. (2025). Streaming messages. https://platform.claude.com/docs/en/build-with-claude/streaming
MDN Web Docs. (2025). Using server-sent events. https://developer.mozilla.org/en-US/docs/Web/API/Server-sent_events/Using_server-sent_events
MDN Web Docs. (2025). Writing WebSocket client applications. https://developer.mozilla.org/en-US/docs/Web/API/WebSockets_API/Writing_WebSocket_client_applications
IETF. (2011). The WebSocket Protocol (RFC 6455). https://www.rfc-editor.org/rfc/rfc6455
Comments :