

AI Video Generatif: Cara Diffusion Belajar Dimensi Waktu
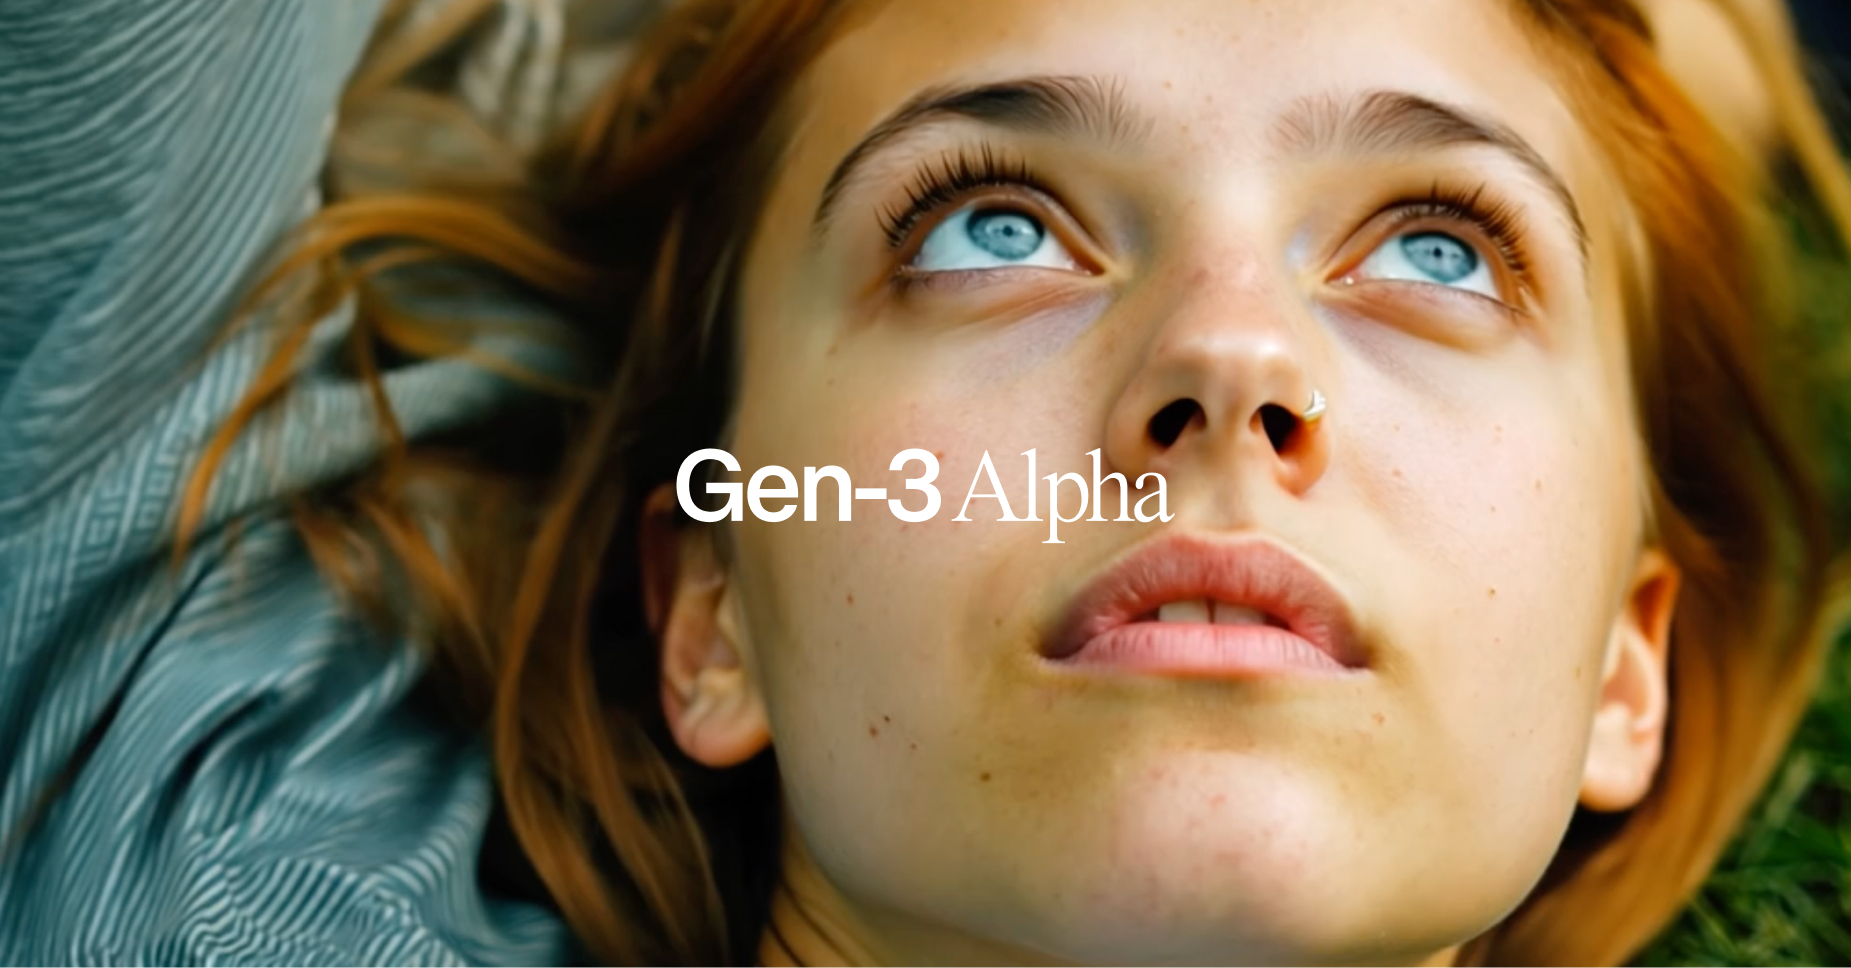
(https://runway.com/research/introducing-gen-3-alpha)
Bayangkan satu kalimat berubah menjadi klip robot pasar malam. Sora, Veo, dan Seedance mewujudkannya lewat aplikasi web. Kamu menulis adegan, model merender gerakan dan kameranya. Artikel SOCS sebelumnya sudah mendaftar model populer. Tulisan ini fokus pada mekanisme diffusion yang memahami waktu.
Apa Itu Diffusion untuk Video?
Diffusion gambar merusak gambar menjadi derau, lalu belajar membalikkannya. Versi video memakai prinsip sama pada frame berurutan. Fondasinya adalah latent diffusion di ruang laten autoencoder. Tim Rombach merilisnya pada 2021 demi memangkas komputasi. Diffusion video adalah pembersih derau yang paham ruang dan waktu.
Cara Kerja AI Video Berbasis Diffusion
Model video modern bertumpu pada empat komponen:
- Kompresi laten: encoder memadatkan video, decoder mengembalikannya ke piksel.
- Spacetime patches: laten dipotong jadi token, gambar dihitung video satu frame.
- Perhatian temporal: lapisan lintas frame menjaga konsistensi objek dan gerakan.
- Pascapelatihan dan distilasi: SFT plus RLHF menyelaraskan output, distilasi memangkas sampling.
Kompresi Sora memampatkan video secara spasial dan temporal. Transformer diffusion membersihkan derau dengan panduan teks prompt. Spacetime patches membuat satu model melayani banyak ukuran. Kreator merender versi vertikal maupun lebar dari model yang sama. Decoder memetakan laten bersih ke piksel, seperti pada Figure 1.
Kepatuhan prompt ditentukan lapisan bahasa di atas fondasi visual. Sora menulis ulang prompt via GPT dengan re-captioning DALL-E 3. Veo 3 merender audio selaras seperti suara jalan dan dialog. Gambar acuan bisa menjadi prompt untuk animasi dan sambungan adegan. Figure 2 menunjukkan rentang gaya yang lahir dari teks.
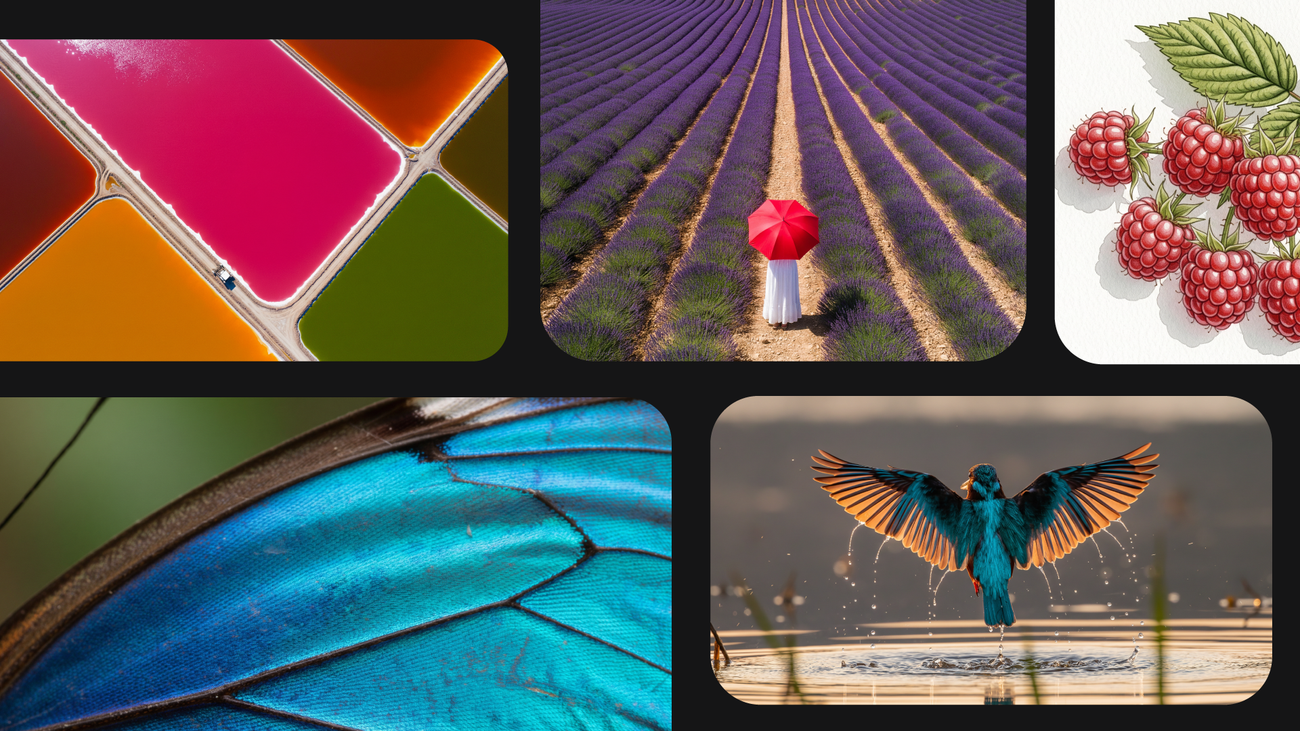
(https://blog.google/innovation-and-ai/products/generative-media-models-io-2025)
Contoh Penggunaan di Dunia Nyata
Animator indie memakai Sora untuk previsi sebelum syuting. Ia menulis gerakan kamera dan mendapat varian klip sekejap. Tim kecil menontonnya untuk menyepakati sudut gambar. Biaya eksplorasi terpangkas sebelum satu frame pun direkam. Pola ini mirip storyboard, hanya medianya video kasar bergerak.
Kreator edukasi memakai Veo untuk video pendek plus sulih suara. Ia menulis naskah dialog dan suasana kelas dalam satu prompt. Model merender tokoh berbicara dengan bibir yang sinkron. Pekerjaan yang dulu butuh studio kini mulai dari laptop. Ia tetap menyunting manual agar faktanya akurat.
Tim kecil memakai Seedance untuk video bertokoh sama. Multi-shot natif menjaga wajah dan gaya lintas adegan. Mode joint text-to-video dan image-to-video memakai foto lokasi asli. RLHF video membuat model patuh pada instruksi multi-subjek. Revisi cepat karena inferensi terpangkas sekitar sepuluh kali lipat.
Sutradara pemula berlatih bahasa kamera lewat Runway dan Pika. Ia mengunggah klip statis lalu mencoba dolly, rotasi, dan zoom. Tiap varian memberi rasa berbeda sehingga ia memilih sudut sadar. Fitur tambah dan hapus objek membersihkan latar. Latihan murah ini membangun intuisi sebelum syuting sungguhan.
Perbandingan Singkat
| Model | Ciri mekanisme | Kontrol |
| Sora | Spacetime patches | Prompt teks, gambar, sambungan |
| Veo | Video plus audio | Prompt teks dan referensi visual |
| Seedance 1.0 | Multi-shot natif T2V/I2V | Narasi multiadegan via RLHF |
| Runway dan Pika | Kontrol temporal | Gerakan kamera dan mode sutradara |
Kelebihan dan Keterbatasan AI Video
- Generalisasi format: satu model melayani banyak durasi dan rasio aspek.
- Kepatuhan prompt: caption deskriptif dan RLHF membuat model taat instruksi.
- Gerakan belum stabil: deformasi dan flicker muncul saat interaksi fisik.
- Biaya dan data: komputasi besar dan isu hak cipta belum tuntas.
Kesimpulan
AI video adalah diffusion gambar yang memahami waktu lewat potongan laten. Tiap brand menekankan sisi berbeda, dari Sora sampai Veo dan Seedance. Bekal ini membantumu menilai demo jernih, bukan sekadar kagum. Ubah satu kata kerja di prompt dan amati gerakannya. Cara membaca mekanisme tetap berguna meski nama model berganti.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
OpenAI. (2024). Video generation models as world simulators. https://openai.com/index/video-generation-models-as-world-simulators
Rombach dkk. (2021). High-Resolution Image Synthesis with Latent Diffusion Models. https://arxiv.org/abs/2112.10752
Gao dkk. (2025). Seedance 1.0: Exploring the Boundaries of Video Generation Models. https://arxiv.org/abs/2506.09113
Google. (2025). Fuel your creativity with new generative media models and tools. https://blog.google/innovation-and-ai/products/generative-media-models-io-2025
Runway. (2024). Runway Gen-3 Alpha: AI Video Generation with Temporal Control. https://runway.com/research/introducing-gen-3-alpha
Comments :