

Small Language Models: AI Canggih yang Muat di HP
(https://huggingface.co/blog/smollm)
Bayangkan asisten AI di HP menjawab sekejap tanpa internet dan datamu tetap di perangkat. Banyak orang mengira kemampuan ini hanya milik raksasa ratusan miliar parameter di pusat data. Anggapan itu usang karena model kecil yang efisien kini menangani tugas harian di HP dan laptop. Small language models (SLM) adalah model bahasa mungil yang dirancang hemat untuk perangkat terbatas. Sejak 2024, Phi-3 dari Microsoft, Gemma dari Google, dan SmolLM dari Hugging Face menunjukkan data bagus mengalahkan ukuran mentah. Artikel ini menjelaskan mengapa model kecil bisa pintar, bagaimana kuantisasi memadatkannya, dan kapan kamu sebaiknya memilih SLM.
Apa Itu Small Language Models?
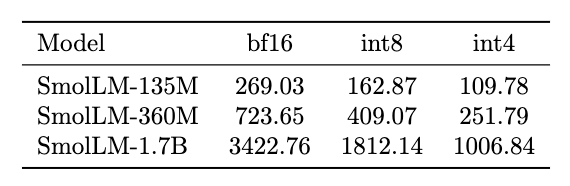
SLM adalah model bahasa jauh di bawah model frontier, dari ratusan juta sampai belasan miliar parameter. Ukurannya muat di memori HP dan laptop sehingga inferensi berjalan tanpa server. Microsoft memperkenalkan Phi-3 pada 2024 lewat varian mini 3,8 miliar parameter yang dilatih pada 3,3 triliun token. Google merilis Gemma 2B dan 7B dari teknologi yang sama dengan model Gemini. Hugging Face merilis SmolLM 135M, 360M, dan 1,7B parameter pada 2024 lengkap dengan korpus terbukanya, dan jejak memorinya terlihat pada Figure 1.
Cara Kerja Small Language Models dan Kuantisasi
Model kecil menjadi pintar karena materi latihnya mirip buku pelajaran yang rapi. Dataset Phi-3 memadukan data web publik yang disaring ketat dengan data sintetis bergaya buku teks. Korpus SmolLM berisi Cosmopedia v2 dengan 28B token sintetis, Python-Edu dengan 4B token Python edukatif, dan FineWeb-Edu dengan 220B token web edukatif yang dideduplikasi. Arsitekturnya hemat karena varian kecil SmolLM memakai Grouped-Query Attention dan mengutamakan depth over width. Kurikulum bersih membuat model kecil belajar bahasa, matematika, dan kode dengan porsi latihan lebih sedikit:
- Kuantisasi 4-bit: mengubah bobot presisi tinggi menjadi bilangan bulat pendek sehingga berkas menyusut dan inferensi melaju.
- Distilasi: melatih model kecil meniru jawaban model besar agar perilakunya mendekati gurunya dengan biaya murah.
- Runtime on-device: menjalankan berkas padat lewat llama.cpp tanpa dependensi, atau lewat format ONNX dan WebGPU di peramban.
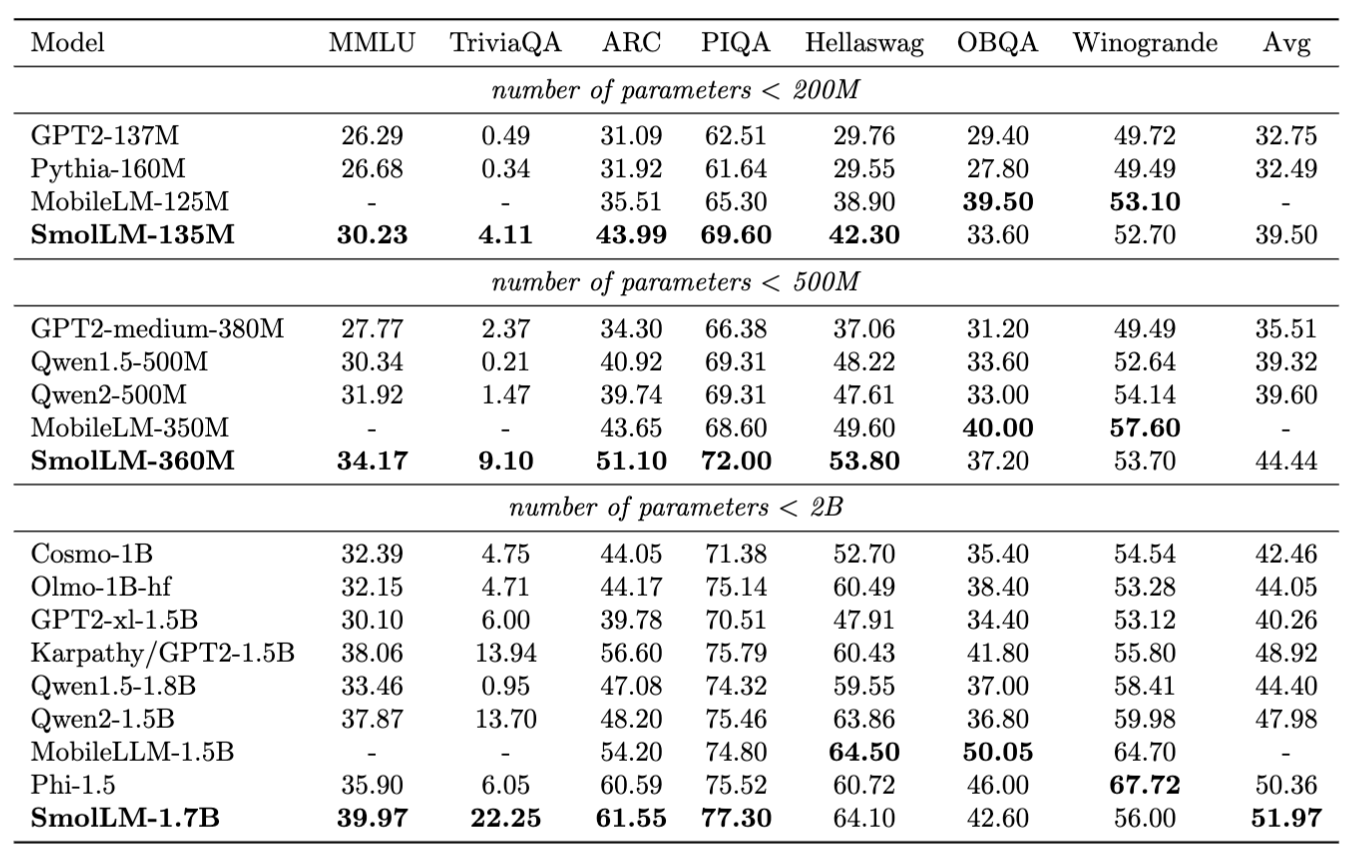
Proyek llama.cpp yang muncul sejak 2023 mendukung kuantisasi integer 1,5-bit sampai 8-bit untuk inferensi hemat memori. Tim SmolLM merilis checkpoint ONNX dan merencanakan versi GGUF yang cocok dengan llama.cpp. Mereka juga menyediakan demo WebGPU agar model kecil berjalan di peramban. Hasilnya model kecil menjawab langsung di perangkat tanpa antre ke server. Gambaran keunggulannya tampil pada Figure 2 lewat skor SLM pada tolok ukur pengetahuan umum.
(https://huggingface.co/blog/smollm)
Contoh Penggunaan di Dunia Nyata
Asisten luring di HP menjadi contoh terdekat karena Phi-3-mini berjalan di ponsel dan merangkum catatan saat sinyal hilang. Perusahaan menjaga data sensitif di dalam gedung karena model seukuran Gemma berjalan di laptop tanpa mengirim dokumen keluar. Pengembang web menyematkan model kecil lewat demo WebGPU SmolLM sehingga pelengkapan teks berjalan di peramban. Pembuat perangkat memakai SLM untuk perintah suara di jam atau kamera pintar karena jeda rendah dan baterai awet. Tim Hugging Face melaporkan SmolLM 1,7B mengungguli model lain di bawah 2B parameter pada tolok ukur akal sehat.
| Aspek | SLM | LLM besar |
| Ukuran | Ratusan juta hingga belasan miliar | Ratusan miliar |
| Lokasi jalan | HP, laptop, peramban | Server dan cloud |
| Privasi | Data tetap di perangkat | Data dikirim ke server |
| Latensi dan biaya | Rendah, dekat pengguna | Tinggi, antre jaringan |
| Reasoning | Cukup untuk tugas umum | Kuat pada soal kompleks |
Kelebihan dan Keterbatasan
Kelebihan utama SLM adalah privasi terjaga, jeda rendah, dan biaya murah karena inferensi terjadi di perangkat. Mahasiswa bisa mengunduh dan mengujinya di laptop biasa tanpa sewa GPU mahal. Keterbatasannya tampak pada soal berlapis seperti pembuktian panjang karena kapasitas memorinya terbatas. Model kecil juga mudah meniru gaya data latihnya sehingga butuh evaluasi jujur pada tolok ukur umum. Nilailah tugasmu dulu karena SLM pas untuk asisten harian, sedangkan riset berat tetap butuh model besar.
Kesimpulan
Kepintaran model kecil lahir dari kurikulum bersih, arsitektur hemat, dan kompresi seperti kuantisasi. Resep terbuka SmolLM plus runtime seperti llama.cpp, ONNX, dan WebGPU menjelaskan mengapa HP biasa kini menjalankan asisten tanggap. Ke depan pola hibrida akan umum, yaitu SLM menangani tugas rutin di perangkat dan hanya soal sulit diteruskan ke cloud. Korpus publik ini memberi bahan eksperimen skala tugas kuliah yang bisa kamu tiru. Mulailah dari satu pertanyaan praktis di sekitarmu, lalu uji mana yang cukup dijawab model kecil di perangkatmu.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Microsoft. (2024). Phi-3 Technical Report. https://arxiv.org/abs/2404.14219
Hugging Face. (2024). SmolLM. https://huggingface.co/blog/smollm
Google. (2024). Gemma: Introducing New State-of-the-Art Open Models. https://blog.google/innovation-and-ai/technology/developers-tools/gemma-open-models/
Google. (2026). Gemma Models Overview. https://ai.google.dev/gemma/docs
ggml-org. (2023). llama.cpp. https://github.com/ggml-org/llama.cpp
Comments :