

Autoencoder: Neural Network yang Belajar dengan Cara ‘Memadatkan dan Membangun Ulang’
Kebanyakan model machine learning yang kita kenal butuh data berlabel, contohnya gambar kucing yang ditandai label ‘kucing’, email spam yang ditandai label ‘spam’, dan seterusnya. Tapi gimana kalau kita punya segunung data tanpa label sama sekali? Apakah AI masih bisa belajar sesuatu yang berguna dari segunung data tersebut? Jawabannya bisa, dan salah satu caranya adalah lewat autoencoder, sebuah neural network unik yang belajar dengan cara mencoba ‘membangun ulang’ inputnya sendiri. Yuk kita bongkar cara kerjanya!
Belajar dengan Meniru Diri Sendiri
Autoencoder adalah jenis neural network yang termasuk unsupervised learning, yaitu belajar tanpa butuh label. Tugasnya mengambil sebuah input, lalu menghasilkan output yang semirip mungkin dengan input itu sendiri. Lho, kalau cuma mau menyalin, apa gunanya?
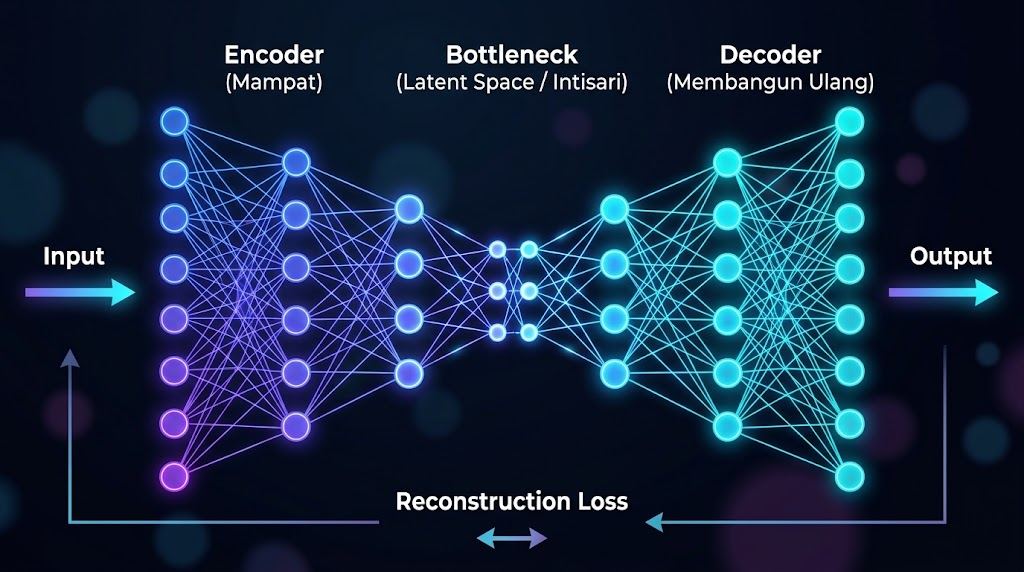
Rahasianya ada pada satu batasan penting. Di tengah jaringan, ada bottleneck yang memaksa data melewati ruang berdimensi jauh lebih kecil. Jadi, untuk bisa membangun ulang input dengan baik, jaringan terpaksa belajar merepresentasi data secara efisien, membuang yang nggak penting, menyimpan yang inti.
Anatomi Autoencoder
Autoencoder terdiri dari tiga bagian utama:
- Encoder, berfungsi memampatkan data input menjadi representasi berdimensi rendah. Bayangkan encoder ini merangkum gambar menjadi beberapa angka inti saja.
- Bottleneck (latent space), yaitu ruang terkompresi di tengah yang menyimpan representasi paling padat dari data. Inilah ‘intisari’ yang dipelajari jaringan.
- Decoder, bertugas untuk mengambil representasi padat itu dan berusaha merekonstruksi data asli dari situ.
Bagaimana Proses Trainingnya?
Jaringan dilatih secara end-to-end menggunakan fungsi kerugian yang disebut reconstruction loss. Model menghitung seberapa jauh perbedaan antara input asli  dan output rekonstruksi
 , biasanya menggunakan metrik seperti Mean Squared Error (MSE) atau Binary Cross-Entropy. Lewat algoritma backpropagation, bobot (weights) pada encoder dan decoder terus diperbarui hingga loss mencapai angka terkecil. Lewat proses ini, encoder belajar memampatkan, dan decoder belajar membangun ulang.
Variasi Arsitektur: Undercomplete vs Overcomplete
Dalam merancang bottleneck, ada dua pendekatan utama:
- Undercomplete Autoencoder, yaitu ukuran latent space dibuat lebih kecil daripada dimensi input. Hal ini memaksa jaringan untuk membuang noise dan hanya mengekstrak fitur paling dominan.
- Overcomplete Autoencoder, yaitu ukuran latent space justru dibuat lebih besar daripada dimensi input. Jika dibiarkan tanpa aturan, model hanya akan menyalin input secara mentah (identity function) tanpa mempelajari apa pun. Oleh karena itu, arsitektur ini membutuhkan teknik regularisasi, seperti Sparse Autoencoder atau Denoising Autoencoder agar hanya neuron–neuron tertentu yang aktif, sehingga jaringan tetap mempelajari fitur bernilai.
Buat Apa Sih Autoencoder?
Kemampuan memampatkan dan merekonstruksi ini ternyata berguna untuk banyak hal:
- Dimensionality reduction, mirip Principal Component Analysis (PCA), tetapi lebih powerful karena bisa menangkap hubungan non-linear. Berguna untuk memvisualisasikan atau menyederhanakan data berdimensi tinggi.
- Denoising (menghilangkan noise), dilatih dengan input yang sengaja dirusak/diberi noise, lalu diminta merekonstruksi versi bersihnya. Hasilnya, ia jago membersihkan gambar atau sinyal yang berisik.
- Anomaly detection, bentuk pengaplikasian yang lagi banyak dipakai di industri. Autoencoder dilatih pada data ‘normal’. Saat ada data anomali (mis. transaksi penipuan atau mesin yang mau rusak), autoencoder akan gagal merekonstruksinya dengan baik, terindikasi dari reconstruction loss-nya melonjak. Lonjakan inilah sinyal adanya anomali.\
- Representation learning, di mana representasi padat yang dipelajari bisa dipakai sebagai fitur untuk tugas machine learning lain.
Variational Autoencoder (VAE)
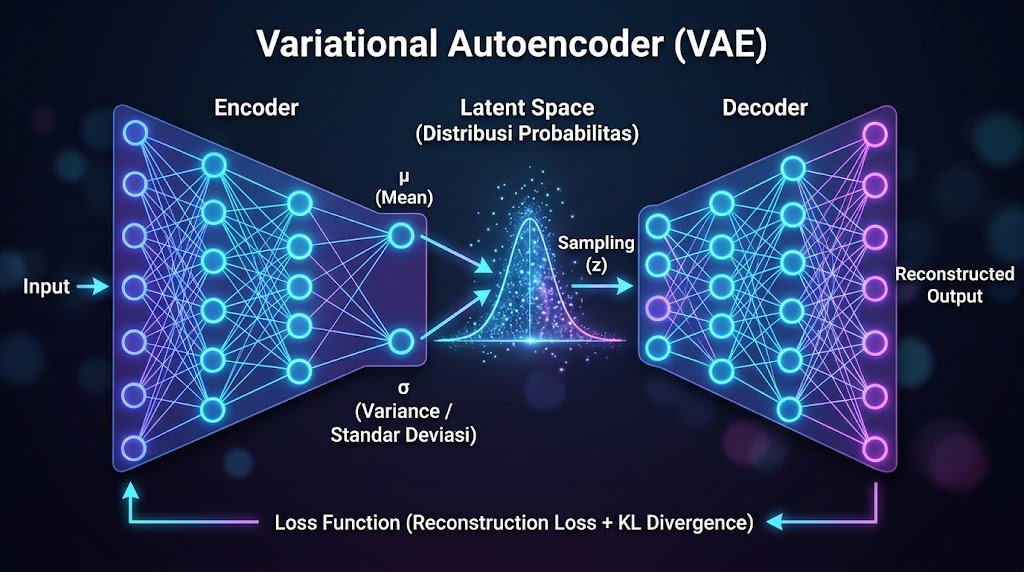
Ada varian penting bernama Variational Autoencoder (VAE) (Kingma & Welling, 2013) yang membawa autoencoder ke ranah generatif. Alih-alih hanya memampatkan data menjadi satu titik konstan, VAE memetakan data ke dalam distribusi probabilitas di latent space-nya. Artinya, kita bisa mengambil sampel dari ruang itu untuk menghasilkan data baru yang mirip data pelatihannya, tapi belum pernah ada sebelumnya.
VAE adalah salah satu pelopor di dunia generative AI, dan konsepnya berkaitan erat dengan model-model generatif modern. Jadi, autoencoder bukan cuma soal kompresi, dia juga akar dari sebagian teknologi AI yang bisa berkreasi.
Penutup
Autoencoder menunjukkan pendekata yang cerdas dengan memaksa neural network memampatkan lalu membangun ulang data, ia belajar menangkap esensi dari informasi tanpa perlu satu pun label. Dari menghilangkan noise, mendeteksi anomali, sampai menghasilkan data baru lewat VAE, autoencoder adalah salah satu arsitektur paling serbaguna di deep learning. Terkadang, cara terbaik untuk memahami sesuatu adalah dengan mencoba membangunnya ulang dari nol.
Penulis
Felicia Natania Lingga, S.Kom. — FDP Scholar
Referensi
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. (Bab 14: Autoencoders).
Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., … & Bengio, Y. (2014). Generative Adversarial Nets. Advances in Neural Information Processing Systems (NIPS) 27.
Hinton, G. E., & Salakhutdinov, R. R. (2006). Reducing the Dimensionality of Data with Neural Networks. Science, 313(5786), 504–507. DOI: 10.1126/science.1127647
Kingma, D. P., & Welling, M. (2013). Auto-Encoding Variational Bayes. arXiv:1312.6114.
Wikipedia. Autoencoder. https://en.wikipedia.org/wiki/Autoencoder
Comments :