

GraphRAG vs Vector RAG: Ketika AI Mulai Memahami Hubungan Antar Data
(https://arxiv.org/abs/2404.16130)
Bayangkan kamu sedang mengembangkan aplikasi AI untuk mencari informasi dari ribuan dokumen. Ketika ditanya tentang suatu teknologi, AI mungkin bisa menemukan dokumen yang relevan. Namun, bagaimana jika pertanyaannya meminta penjelasan tentang hubungan teknologi tersebut dengan risiko keamanan, sistem lain, atau tren yang tersebar di banyak dokumen? Menemukan potongan teks yang mirip belum tentu cukup. AI perlu menghubungkan informasi yang ditemukan agar dapat menyusun jawaban yang lebih menyeluruh. Di sinilah GraphRAG menarik untuk dibahas. Pendekatan ini memanfaatkan knowledge graph untuk membantu AI menghubungkan informasi dari berbagai sumber. Lalu, apa bedanya dengan Vector RAG, dan kapan masing-masing pendekatan lebih cocok digunakan?
Apa Itu Vector RAG dan GraphRAG?
RAG (Retrieval-Augmented Generation) merupakan pendekatan yang mengambil informasi dari sumber eksternal untuk dijadikan konteks bagi Large Language Model (LLM) ketika menghasilkan jawaban. Pada Vector RAG, dokumen biasanya dibagi menjadi potongan-potongan teks (chunks), kemudian direpresentasikan sebagai embedding, yaitu vektor numerik yang menangkap makna teks. Saat pengguna mengajukan pertanyaan, sistem mencari potongan yang paling relevan berdasarkan kemiripan semantik, lalu memberikan hasilnya kepada LLM sebagai konteks.
Sementara itu, GraphRAG menggabungkan proses pencarian informasi dengan knowledge graph, yaitu struktur data yang merepresentasikan entitas dan hubungan di antara entitas tersebut. Contohnya, sebuah graf dapat menghubungkan perusahaan dengan produk, teknologi dengan dependensinya, atau sistem dengan kerentanan yang berkaitan dengannya. Pendekatan GraphRAG untuk menjawab pertanyaan yang membutuhkan sintesis informasi lokal maupun global dipopulerkan melalui penelitian Microsoft Research pada 2024. Meski begitu, GraphRAG tidak otomatis lebih baik untuk semua kebutuhan. Vector RAG tetap efektif untuk banyak tugas pencarian, sedangkan GraphRAG menjadi menarik ketika hubungan antardata dan tema lintas dokumen berperan penting dalam jawaban.
Bagaimana GraphRAG Bekerja?
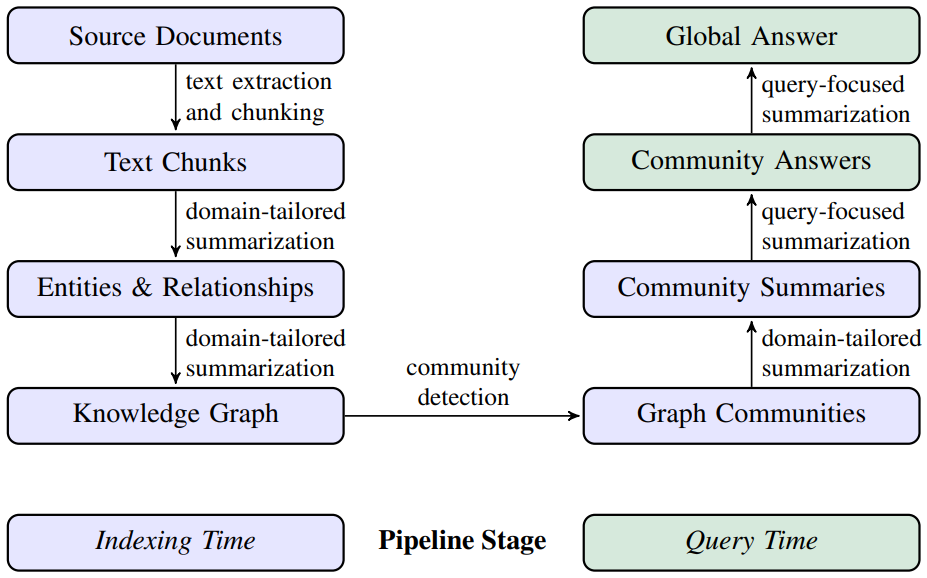
GraphRAG memiliki tahapan pemrosesan data sebelum sistem digunakan untuk menjawab pertanyaan. Pada pendekatan yang diperkenalkan Microsoft Research, alur ini mencakup pembuatan graf, pendeteksian komunitas, serta penyusunan ringkasan yang membantu menjawab pertanyaan dengan cakupan berbeda.
Secara umum, prosesnya dapat dijelaskan melalui tahapan pada figure 1 berikut:
- Document Processing: Dokumen diekstrak dan dibagi menjadi potongan teks agar lebih mudah diproses.
- Entity and Relationship Extraction: Sistem mengidentifikasi entitas serta hubungan yang disebutkan dalam teks.
- Knowledge Graph Construction: Entitas direpresentasikan sebagai nodes, sedangkan hubungan antardata menjadi edges.
- Community Detection and Summarization: Sistem mengelompokkan entitas yang saling terhubung menjadi komunitas, lalu menyusun ringkasan untuk membantu memahami tema yang lebih luas.
- Query and Answer Generation: Informasi atau ringkasan yang relevan digunakan untuk membantu LLM menyusun jawaban sesuai pertanyaan pengguna.
Tahap indexing umumnya dilakukan sebelum pertanyaan diajukan. Ketika pengguna mengirim pertanyaan, sistem memanfaatkan hasil pemrosesan tersebut sesuai strategi pencarian yang digunakan. Misalnya, pertanyaan tentang satu entitas dapat membutuhkan informasi yang spesifik, sedangkan pertanyaan tentang tema besar dalam kumpulan dokumen dapat memerlukan ringkasan dari beberapa komunitas.
Melihat Alur Basic GraphRAG
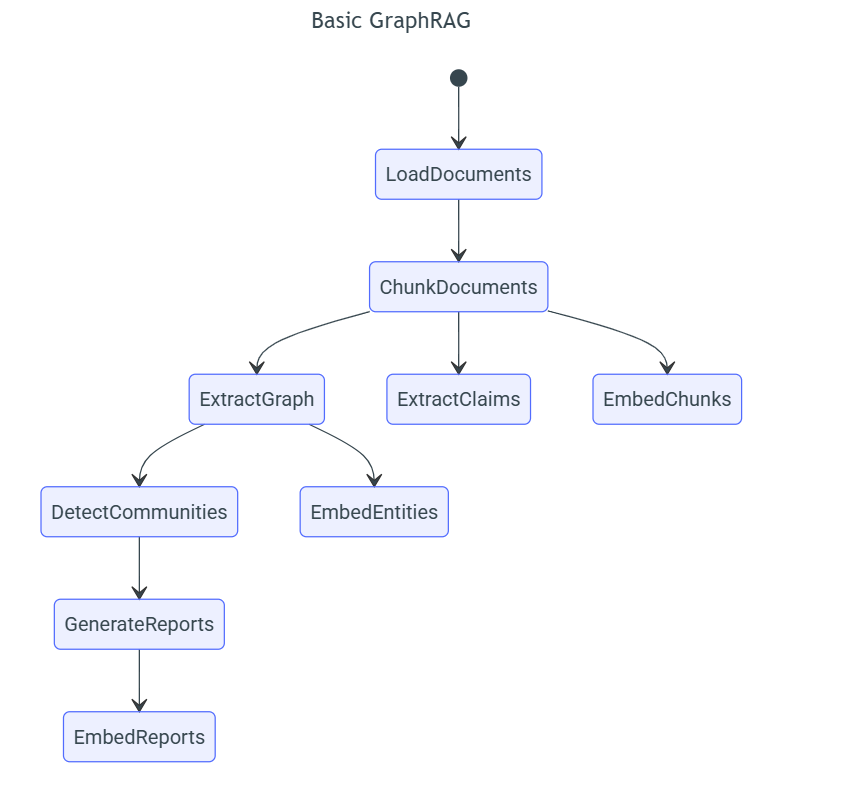
Untuk memahami prosesnya dengan lebih konkret, kita bisa melihat diagram alur Basic GraphRAG berikut.
(https://microsoft.github.io/graphrag/index/architecture/)
Diagram ini menunjukkan bahwa dokumen terlebih dahulu dimuat dan dibagi menjadi chunks. Setelah itu, beberapa proses dapat berjalan untuk mengekstrak graf, mengekstrak klaim, dan membuat embedding untuk potongan teks. Dari hasil ekstraksi graf, sistem dapat mendeteksi komunitas dan membuat representasi tambahan, seperti embedding entitas. Informasi komunitas kemudian digunakan untuk menghasilkan laporan atau ringkasan yang dapat membantu proses pencarian dan penyusunan jawaban. Perlu diingat, diagram tersebut menggambarkan alur implementasi tertentu, bukan satu-satunya arsitektur yang wajib diikuti semua sistem GraphRAG. Detail proses dapat berbeda bergantung pada framework, konfigurasi, dan kebutuhan aplikasi.
Perbandingan Vector RAG dan GraphRAG
| Aspek | Vector RAG | GraphRAG |
| Struktur utama | Potongan teks dan embedding | Entitas, relasi, dan informasi teks; dapat disertai embedding |
| Cara mencari | Kemiripan semantik | Dapat memanfaatkan relasi graf, teks, dan ringkasan |
| Pertanyaan spesifik | Cocok untuk menemukan informasi relevan | Berguna jika pertanyaan membutuhkan konteks relasional |
| Analisis lintas dokumen | Bergantung pada potongan yang berhasil ditemukan dan strategi retrieval | Dapat membantu sintesis melalui hubungan dan ringkasan komunitas |
| Kompleksitas | Umumnya lebih sederhana | Umumnya lebih kompleks |
| Biaya persiapan data | Biasanya lebih rendah | Dapat lebih tinggi karena ekstraksi graf dan pembuatan ringkasan |
| Contoh penggunaan | FAQ dan pencarian dokumentasi | Analisis hubungan antarsistem dan sintesis pengetahuan lintas dokumen |
Perbedaan ini bukan berarti Vector RAG hanya dapat mencari satu dokumen atau GraphRAG selalu mampu memahami keseluruhan data. Kualitas hasil tetap bergantung pada sumber, strategi retrieval, model yang digunakan, serta cara sistem mengevaluasi jawaban.
Contoh Penggunaan di Dunia Nyata
GraphRAG dan Vector RAG dapat diterapkan untuk kebutuhan yang berbeda maupun digabungkan dalam satu sistem.
- Dokumentasi perusahaan: Vector RAG dapat membantu menemukan panduan teknis, sedangkan GraphRAG dapat membantu menelusuri hubungan antarlayanan dan dependensinya.
- Keamanan siber: Graf dapat menghubungkan aset, sistem, dan kerentanan berdasarkan informasi yang tersedia sehingga analis lebih mudah menelusuri keterkaitannya.
- Penelitian akademik: GraphRAG dapat membantu menyusun gambaran hubungan antarkonsep dari berbagai publikasi.
- Knowledge management: Organisasi dapat memanfaatkan pencarian semantik dan hubungan antardata untuk menemukan informasi yang tersebar di berbagai dokumen.
Dalam praktiknya, pendekatan hibrida juga memungkinkan. Vector retrieval dapat digunakan untuk menemukan potongan teks yang relevan, sementara informasi graf membantu memberikan konteks relasional tambahan.
Kelebihan dan Keterbatasan
Vector RAG menawarkan implementasi yang relatif sederhana dan efektif untuk pencarian semantik. Namun, jika jawaban membutuhkan hubungan yang tersebar di berbagai dokumen, sistem mungkin memerlukan strategi retrieval tambahan agar konteks yang terkumpul cukup lengkap. GraphRAG dapat membantu mengorganisasi hubungan antardata dan menyusun ringkasan untuk analisis yang lebih luas. Di sisi lain, ekstraksi entitas dan relasi membutuhkan pemrosesan tambahan, yang dapat meningkatkan biaya dan waktu indexing. Relasi yang keliru atau ringkasan yang tidak akurat juga dapat memengaruhi kualitas jawaban. Karena itu, penggunaan GraphRAG perlu disesuaikan dengan kebutuhan. Jika aplikasi hanya perlu mencari jawaban dari dokumentasi atau FAQ, Vector RAG mungkin sudah memadai. Namun, jika pertanyaan sering menuntut analisis hubungan antardata dan sintesis dari banyak dokumen, GraphRAG layak dipertimbangkan.
Pada akhirnya, tujuan RAG bukan sekadar menemukan teks, melainkan menyediakan konteks yang tepat agar AI dapat menghasilkan jawaban yang berguna. Vector RAG dan GraphRAG menawarkan cara berbeda untuk mencapai tujuan tersebut. Pilihan terbaik bukanlah teknologi yang paling kompleks, tetapi pendekatan yang sesuai dengan jenis pertanyaan, kualitas data, biaya, dan kebutuhan aplikasi.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Microsoft Research. (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv. https://arxiv.org/abs/2404.16130
Microsoft. (n.d.). GraphRAG Documentation: Indexing Overview. https://microsoft.github.io/graphrag/index/overview/
Microsoft. (n.d.). GraphRAG Documentation: Query Engine Overview. https://microsoft.github.io/graphrag/query/overview/
Microsoft. (n.d.). GraphRAG Documentation: Architecture Overview. https://microsoft.github.io/graphrag/index/architecture/
Comments :