

Infinite Context: Akankah RAG Menjadi Warisan Masa Lalu?
Bayangkan kamu sedang mengerjakan proyek penelitian dan harus membaca ratusan dokumen. Apakah lebih baik memasukkan semuanya ke meja kerja agar dapat melihat keseluruhan konteks sekaligus, atau meminta asisten mengambil dokumen yang paling relevan setiap kali dibutuhkan? Dilema ini kini hadir dalam dunia kecerdasan buatan (AI). Context window pada Large Language Model (LLM) semakin besar, bahkan mencapai jutaan token pada model tertentu. Di sisi lain, Retrieval-Augmented Generation (RAG) memungkinkan AI mengambil informasi dari sumber eksternal sesuai kebutuhan. Jika AI sudah mampu memproses begitu banyak informasi sekaligus, apakah RAG masih diperlukan? Jawabannya tidak sesederhana itu. Kapasitas konteks yang besar dan kemampuan mengambil informasi merupakan dua pendekatan berbeda yang justru dapat saling melengkapi.
Memahami Context Window dan RAG
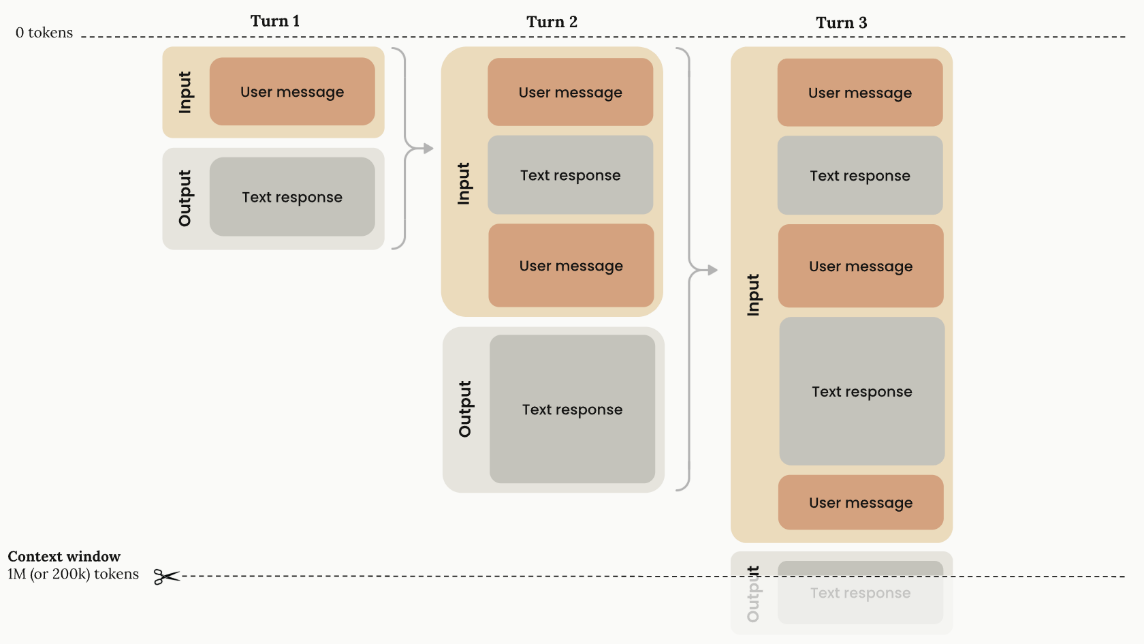
Context window adalah jumlah maksimum token yang dapat ditangani model dalam satu konteks pemrosesan, termasuk pesan, instruksi, hasil penggunaan tools, dan keluaran yang dihasilkan. Token merupakan unit teks yang diproses model; satu token tidak selalu sama dengan satu kata. Karena itu, kapasitas satu juta token tidak dapat langsung diterjemahkan menjadi jumlah halaman yang pasti. Kapasitas efektif bergantung pada bahasa, format, dan isi dokumen. [1]
Seperti terlihat pada Figure 1, setiap giliran percakapan menambahkan pesan pengguna dan respons AI ke konteks berikutnya. Pada Turn 1, konteks masih relatif kecil. Memasuki Turn 2 dan Turn 3, riwayat percakapan semakin panjang karena pesan serta respons sebelumnya ikut diperhitungkan. Garis putus-putus di bagian bawah menggambarkan batas kapasitas konteks: ketika isinya mendekati batas tersebut, sistem perlu mengelola atau mengurangi konteks yang dipertahankan. Dengan demikian, context window besar bukan berarti AI memiliki ingatan permanen atau kapasitas tanpa batas. Konteks tetap memiliki batas, dan semakin banyak informasi yang dimasukkan belum tentu membuat jawaban semakin baik. [1]. Sementara itu, RAG merupakan pendekatan yang menggabungkan proses pencarian informasi eksternal dengan pembuatan jawaban oleh LLM. Ketika pengguna mengajukan pertanyaan, sistem mencari dokumen atau potongan informasi yang relevan, lalu memasukkannya sebagai konteks bagi model. AI kemudian menyusun jawaban berdasarkan pertanyaan dan informasi yang ditemukan.
Apa yang Ditunjukkan Perbandingan Model AI?
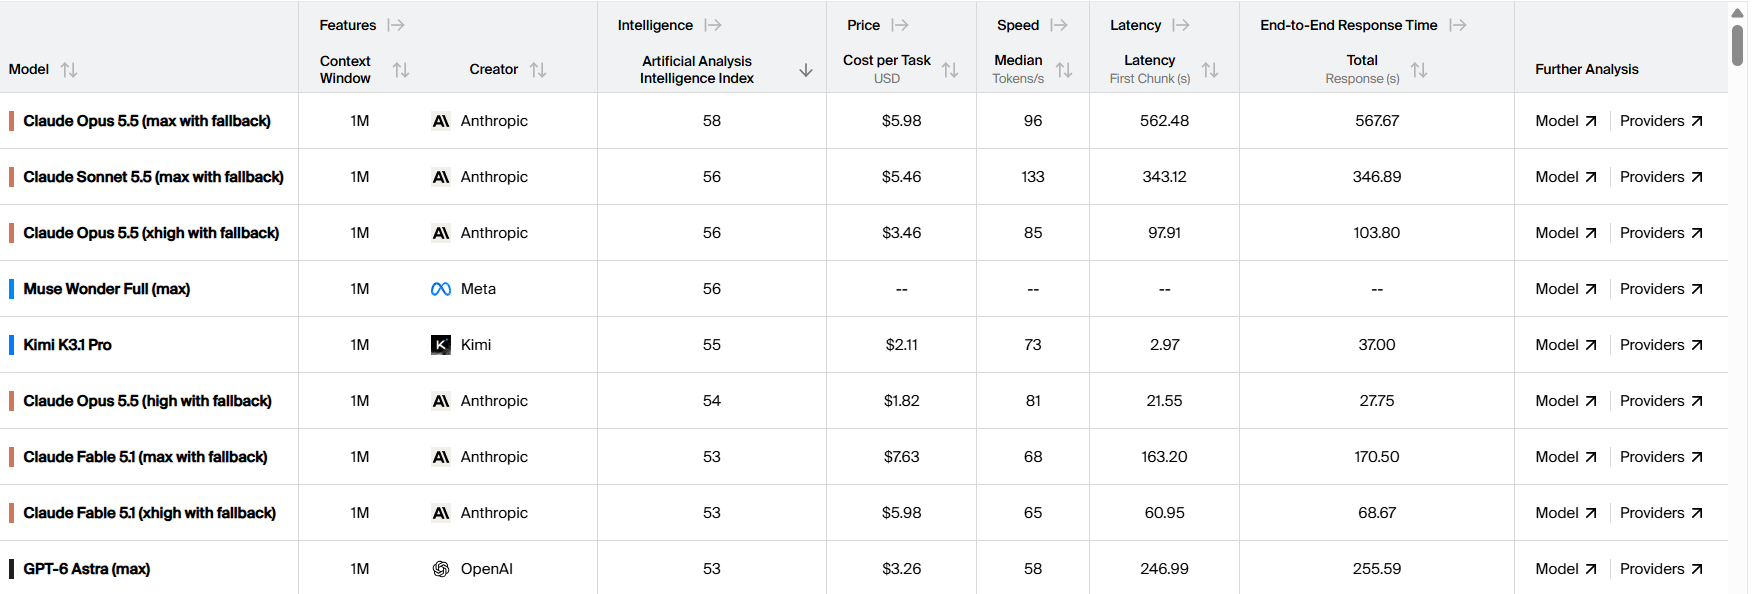
Figure 2. Perbandingan model AI berdasarkan kapasitas context window dan sejumlah metrik operasional, seperti indeks kecerdasan, harga, kecepatan keluaran, latensi, dan waktu respons total.
(https://artificialanalysis.ai/leaderboards/models).
Figure 2 memperlihatkan bahwa kapasitas konteks hanyalah salah satu aspek dalam menilai model AI. Tabel juga memuat indeks kecerdasan, biaya, kecepatan menghasilkan token, latensi awal, dan waktu respons keseluruhan. Artinya, model dengan context window lebih besar belum tentu menjadi pilihan terbaik untuk semua kebutuhan. Misalnya, aplikasi yang harus menganalisis banyak dokumen sekaligus mungkin membutuhkan konteks luas. Sebaliknya, chatbot layanan pelanggan yang menangani banyak permintaan sederhana bisa lebih mengutamakan biaya dan waktu respons. Karena data Artificial Analysis diperbarui dan model yang tersedia terus berubah, gambar tersebut sebaiknya diperlakukan sebagai potret pada saat diambil, bukan peringkat yang berlaku selamanya. [2]
Mengapa RAG Masih Penting?
Context window besar memungkinkan model memproses dokumen panjang tanpa harus selalu memecahnya menjadi banyak bagian. Namun, memasukkan seluruh dokumen bukan selalu cara paling efisien untuk menemukan fakta tertentu. Informasi yang tidak relevan dapat memenuhi konteks, meningkatkan biaya pemrosesan, dan menyulitkan model mengidentifikasi detail penting. RAG menawarkan pendekatan yang lebih terarah.
Sistem dapat mencari bagian dokumen yang sesuai dengan pertanyaan, menyertakan sumbernya, lalu meminta LLM menyusun jawaban berdasarkan hasil pencarian tersebut. Pendekatan ini sangat berguna untuk basis pengetahuan perusahaan, dokumentasi teknis, kebijakan internal, dan informasi yang sering diperbarui. Namun, RAG tidak otomatis menjamin jawaban akurat. Jika dokumen sumber salah, proses pencarian melewatkan informasi penting, atau model salah menafsirkan hasilnya, jawaban tetap dapat keliru. Kualitas RAG bergantung pada mutu data, strategi pencarian, relevansi hasil, dan proses verifikasi.
Context Window Besar vs. RAG
| Aspek | Context Window Besar | RAG |
| Cara kerja | Memasukkan banyak informasi ke konteks model | Mencari informasi yang relevan saat diperlukan |
| Kekuatan utama | Memahami banyak materi dalam satu konteks | Menemukan bukti spesifik dari sumber eksternal |
| Pembaruan data | Perlu memasukkan konteks terbaru | Dapat menggunakan sumber yang diperbarui, jika indeks dan pipeline turut diperbarui |
| Biaya | Dapat meningkat ketika banyak token diproses | Memerlukan infrastruktur pencarian dan pemrosesan konteks hasil retrieval |
| Risiko | Informasi penting dapat terlewat dalam konteks panjang | Hasil pencarian dapat tidak relevan atau tidak lengkap |
Salah satu tantangan pemrosesan konteks panjang adalah fenomena lost in the middle, yaitu ketika model kurang efektif menggunakan informasi yang berada di tengah konteks dibandingkan informasi pada posisi tertentu, seperti bagian awal atau akhir. Fenomena ini tidak selalu terjadi dengan tingkat yang sama pada setiap model dan tugas. Karena itu, evaluasi tetap diperlukan meskipun model memiliki jendela konteks yang luas.
Masa Depan: Bukan Saling Menggantikan
Alih-alih menganggap RAG akan segera menjadi usang, pendekatan yang lebih masuk akal adalah menggabungkannya dengan context window besar. Model dapat menggunakan konteks luas untuk memahami percakapan panjang, dokumen yang saling berkaitan, atau instruksi kompleks, sementara RAG membantu mengambil fakta tertentu dari sumber yang relevan. Sebagai contoh, perusahaan dapat menggunakan RAG untuk mencari kebijakan terbaru, lalu memasukkan dokumen yang ditemukan bersama riwayat percakapan dan instruksi kerja ke context window model. Untuk pertanyaan yang membutuhkan banyak konteks, sistem dapat mengambil beberapa dokumen sekaligus. Untuk pertanyaan sederhana, sistem cukup mengambil informasi yang paling relevan. Kombinasi ini tetap membutuhkan pengendalian akses, evaluasi hasil pencarian, pemeriksaan sumber, dan pengawasan manusia sesuai tingkat risiko penggunaannya. Kapasitas yang besar tidak menggantikan kebutuhan akan data yang baik dan proses validasi.
Context window yang semakin besar memang mengubah cara AI memproses informasi, tetapi tidak otomatis menghilangkan kebutuhan akan RAG. Keduanya menyelesaikan persoalan yang berbeda: context window menyediakan ruang untuk memahami informasi dalam satu konteks, sedangkan RAG membantu menemukan informasi yang relevan dari sumber eksternal. Masa depan AI kemungkinan bukan tentang memilih salah satu, melainkan menentukan kapan informasi perlu dimasukkan langsung ke konteks dan kapan informasi sebaiknya dicari terlebih dahulu. Dengan kombinasi yang tepat, AI dapat memanfaatkan konteks luas sekaligus mempertahankan hubungan dengan sumber informasi yang dapat diperiksa.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
- Anthropic. (n.d.). Context windows. Claude Platform Docs. https://platform.claude.com/docs/en/build-with-claude/context-windows
- Artificial Analysis. (n.d.). LLM Leaderboard. https://artificialanalysis.ai/leaderboards/models
- Microsoft Research. (2024). GraphRAG: Unlocking LLM Discovery on Narrative Private Data. https://www.microsoft.com/en-us/research/blog/graphrag-unlocking-llm-discovery-on-narrative-private-data/
- Amazon Web Services. (n.d.). Retrieval-Augmented Generation (RAG). https://aws.amazon.com/what-is/retrieval-augmented-generation/
- IBM. (n.d.). What is a context window? https://www.ibm.com/think/topics/context-window
Comments :