

Text-to-SQL: Ketika Bahasa Manusia Bisa Berubah Menjadi Query Database
(https://arxiv.org/abs/2305.03111)
Bayangkan kamu membutuhkan daftar lima pelanggan paling aktif sepanjang kuartal terakhir dalam hitungan detik. Di masa lalu, kamu harus menghubungi analis, menunggu antrean tiket, lalu menanti penulisan query yang rumit. Kini, kamu cukup mengetik kalimat tanya di aplikasi percakapan, dan jawaban langsung tersaji. Kemampuan ini membuka aksesibilitas data secara luas. Namun, di balik kemudahan komunikasi tersebut, terdapat jembatan teknis yang menghubungkan fleksibilitas bahasa alami dengan kekakuan sintaks query.
Apa Itu Text-to-SQL?
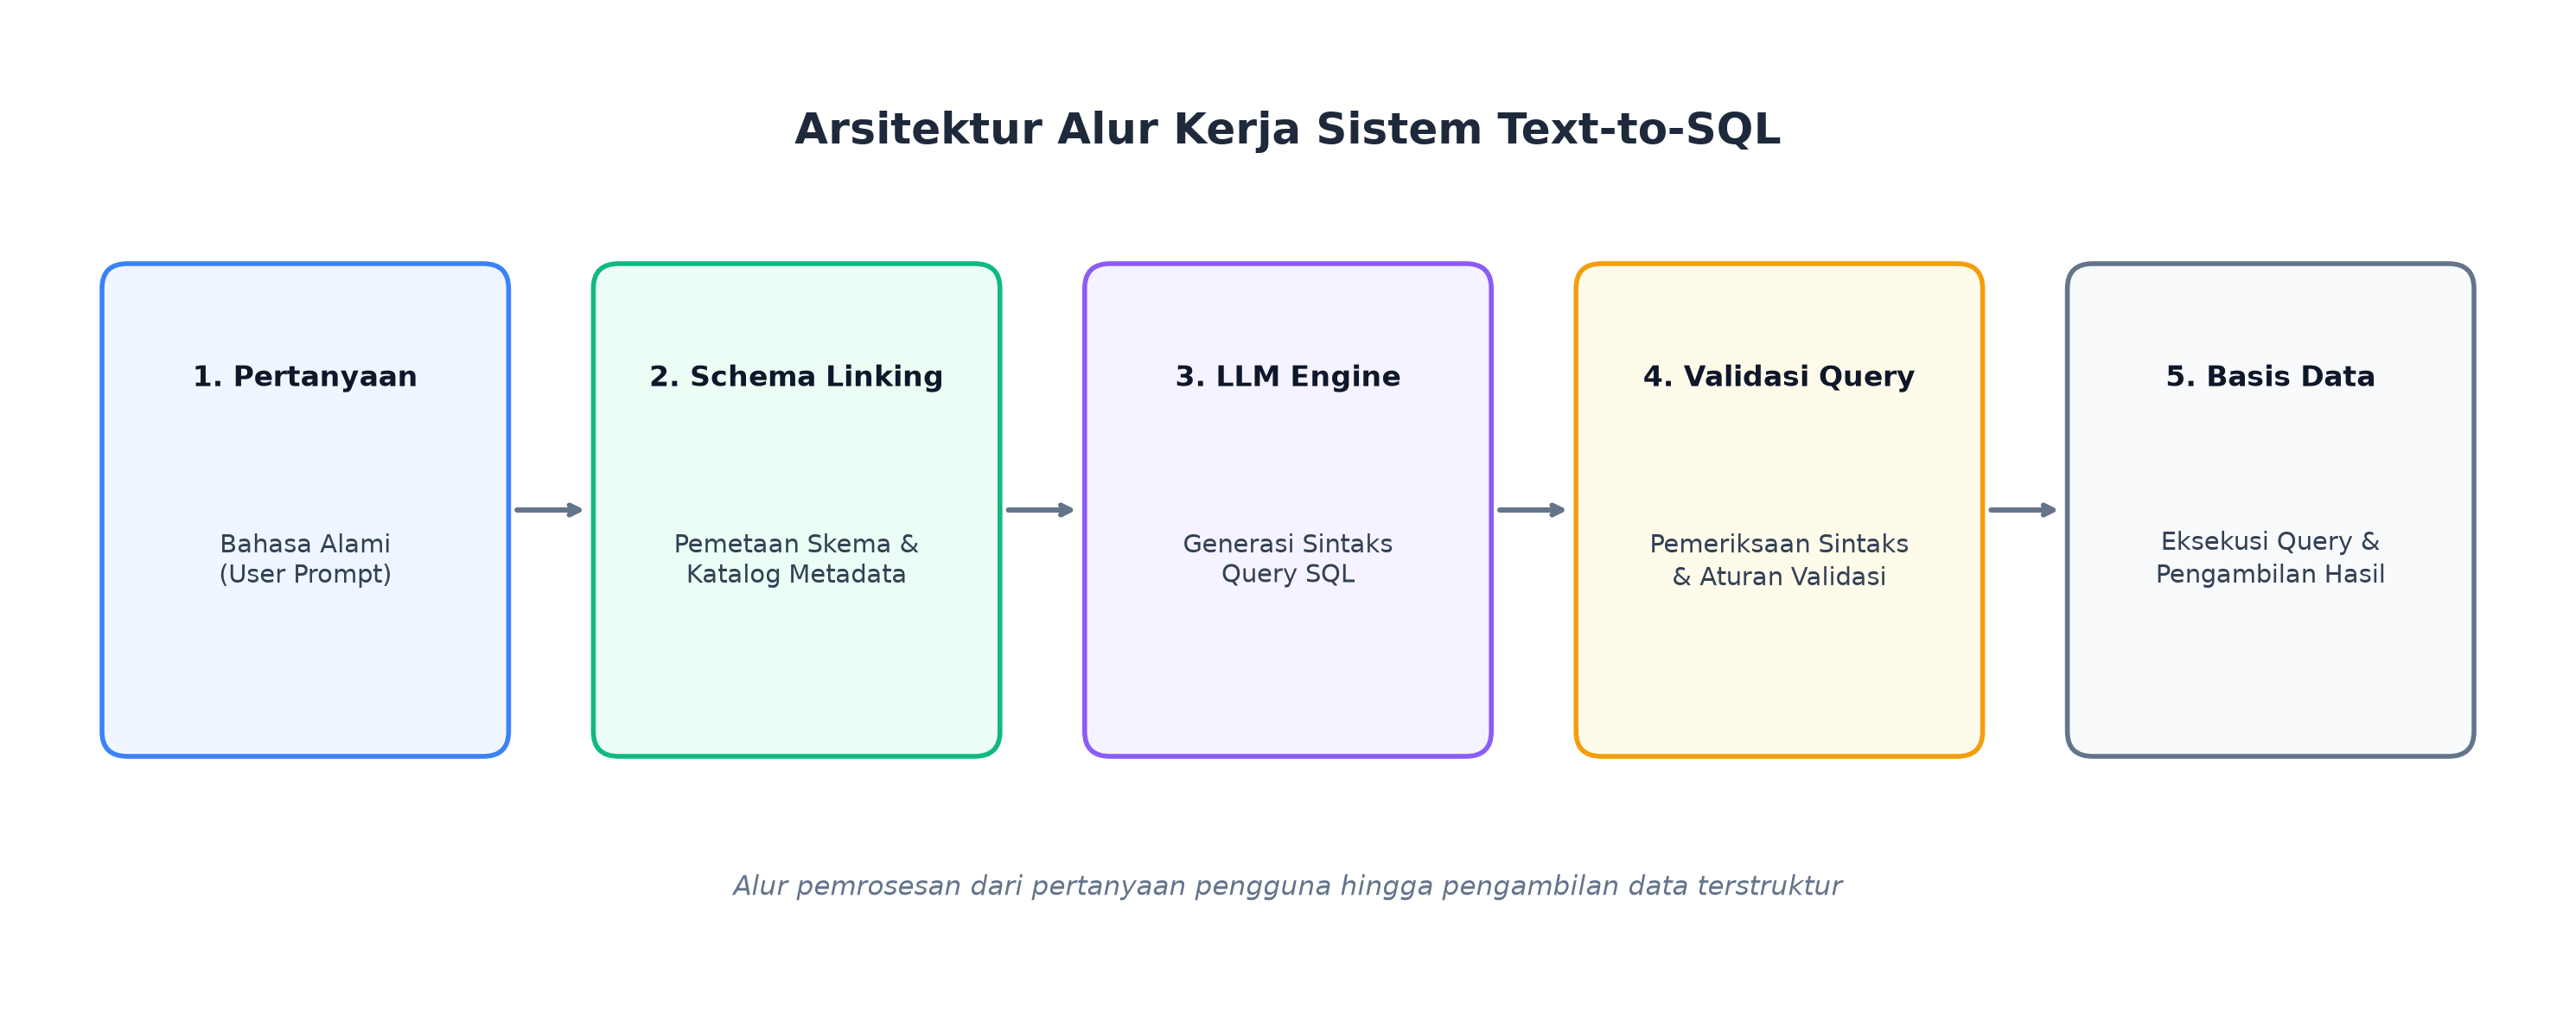
Secara sederhana, text-to-SQL adalah teknologi pemrosesan bahasa alami yang menerjemahkan pertanyaan manusia menjadi query SQL untuk dieksekusi basis data. Teknologi ini meruntuhkan sekat teknis antara pengguna bisnis dan gudang data, memungkinkan eksplorasi informasi tanpa perlu menghafal sintaks query. Riset ini berkembang pesat sejak peneliti Tao Yu dan tim dari Universitas Yale merilis dataset Spider pada 2018, yang menghimpun 10.181 pertanyaan serta 5.693 query SQL unik. Kehadiran model bahasa besar kini memperluas kemampuannya dalam memahami variasi semantik kalimat yang jauh lebih luwes. Hasilnya tetap bergantung pada kesesuaian skema basis data dan konteks pertanyaan. Alurnya ditunjukkan pada figure 1.
Bagaimana Arsitektur Text-to-SQL Bekerja?
- Schema Linking: memetakan maksud pertanyaan ke tabel dan kolom relevan melalui katalog metadata.
- Prompt Construction: merangkai skema basis data, relasi tabel, dan contoh query ke dalam konteks model.
- SQL Generation: memproduksi sintaks query terstruktur sesuai dialek basis data yang dituju.
- Query Validation: membedah validitas sintaks dan aturan pemeriksaan sebelum query dieksekusi.
(https://arxiv.org/abs/2305.03111)
Mengapa Schema Database dan Validasi Tetap Krusial?
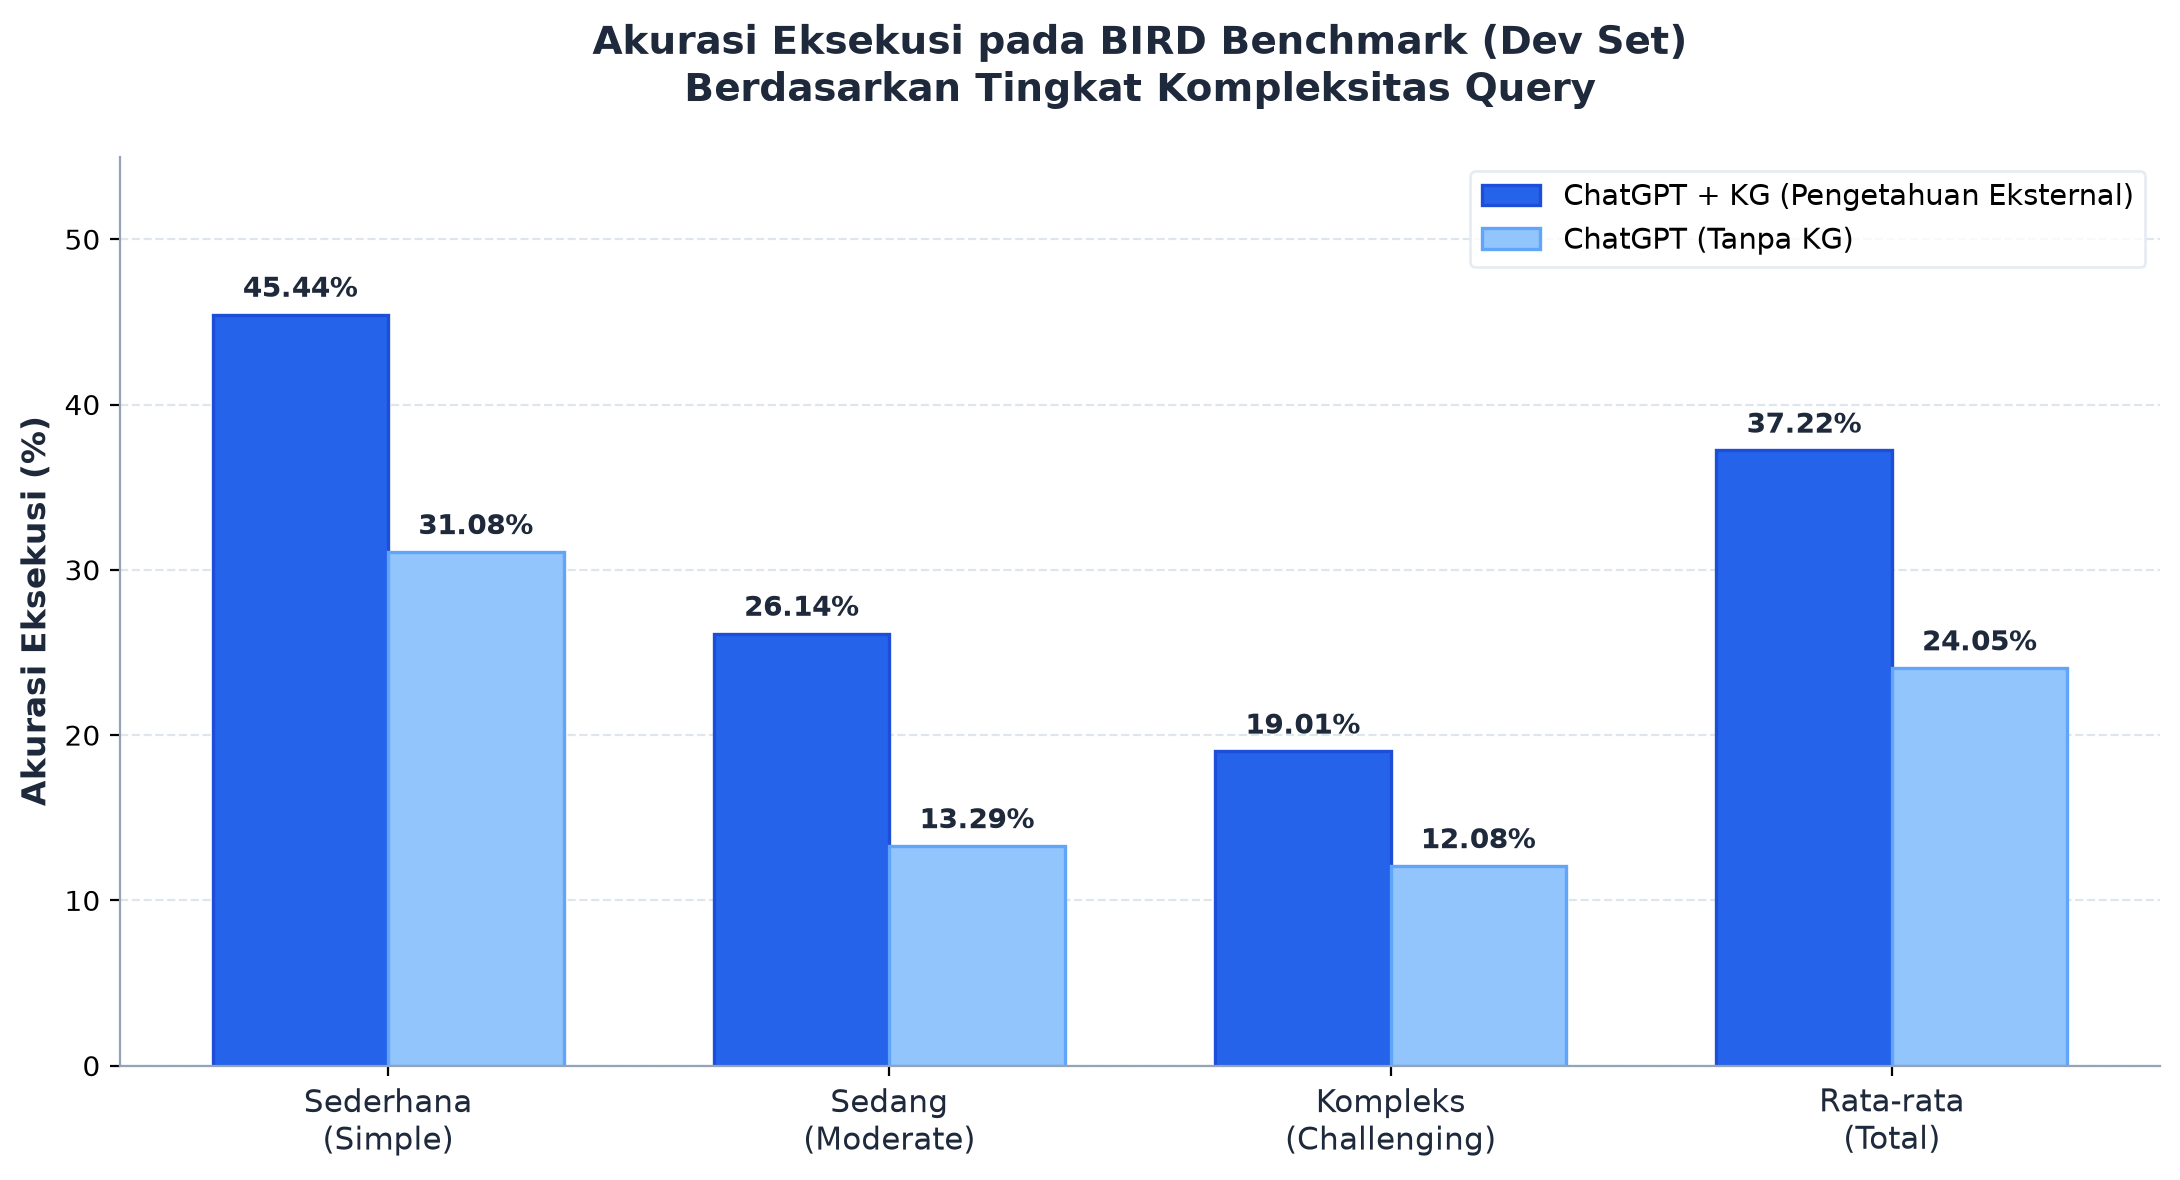
Meskipun model bahasa mampu merangkai kode dengan cepat, basis data enterprise menyimpan aset krusial yang rentan terhadap salah tafsir. Jika skema tidak dipetakan dengan presisi, model dapat mengalami halusinasi dengan mengarang nama kolom fiktif. Tanpa pembatasan hak akses, manipulasi input pengguna dapat memicu perintah destruktif seperti penghapusan tabel. Eksperimen Li dan tim (2023) pada benchmark BIRD terhadap 95 basis data berukuran 33,4 GB menunjukkan bahwa akurasi eksekusi model ChatGPT dengan penambahan basis pengetahuan (ChatGPT+KG) turun hingga 19,01% pada data pengembangan (dev set) untuk query kompleks. Figure 2 memvisualisasikan angka tersebut. Oleh sebab itu, berbagai penyedia teknologi menerapkan mekanisme pengamanan: Amazon Web Services pada solusi text-to-SQL terbarunya memakai validator deterministik yang memeriksa query sebelum dieksekusi dan mengulang pembuatan query secara otomatis jika validasi gagal; Google Cloud memakai validasi dry run dan re-prompting setelah kesalahan; sedangkan kerangka kerja LangChain menyarankan memeriksa query SQL sebelum eksekusi serta menerapkan mekanisme human-in-the-loop.
| Aspek | Pendekatan Berbasis Aturan | Pendekatan Berbasis LLM |
| Fleksibilitas Bahasa | Terpaku pada pola kaku | Memahami variasi bahasa alami |
| Adaptasi Skema | Perlu konfigurasi manual ulang | Adaptif lewat injeksi metadata |
| Query Bertingkat | Sulit mengurai logika rumit | Menyusun klausa bertingkat dinamis |
| Risiko Halusinasi | Rendah, karena aturan tetap | Ada potensi salah memilih kolom |
| Validasi Wajib | Uji sintaks dasar | Pemeriksaan query dan kontrol akses |
Kelebihan dan Keterbatasan
Implementasi text-to-SQL mempercepat pengambilan keputusan karena memangkas antrean permintaan data dari harian menjadi hitungan detik. Tim non-teknis memperoleh otonomi tinggi dalam menganalisis tren bisnis secara mandiri. Karyawan dapat mengajukan pertanyaan lanjutan tanpa harus memahami struktur tabel lebih dulu. Hal ini memperpendek jarak antara kebutuhan informasi dan proses analisis. Peran analis pun dapat bergeser ke validasi metrik serta tata kelola data.
Kendati demikian, tantangan nyata tetap hadir dari data kotor dan inkonsistensi singkatan bisnis internal. Tanpa pengawasan, model juga berisiko menghasilkan query berat yang membebani kinerja server basis data. Query yang tampak benar juga bisa memakai definisi metrik yang keliru. Akses hanya-baca dan batas waktu eksekusi membantu mengendalikan dampak kesalahan. Pengawasan tetap dibutuhkan terutama ketika hasil dipakai untuk keputusan bisnis.
Kesimpulan
Perkembangan text-to-SQL telah mentransformasi interaksi data modern menjadi jauh lebih inklusif dan efisien. Namun, kecerdasan buatan hanyalah jembatan komunikasi, sementara integritas serta keamanan informasi tetap bertumpu pada disiplin arsitektur basis data. Keberhasilan sistem tidak hanya ditentukan oleh kemampuan model menerjemahkan bahasa, tetapi juga mutu skema dan kontrol yang menyertainya. Pengguna sebaiknya memulai dari pertanyaan yang jelas dan data yang memang boleh diakses. Dengan begitu, kemudahan bertanya tetap sejalan dengan keamanan dan keandalan analisis.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Amazon Web Services. (2026). Text-to-SQL solution powered by Amazon Bedrock. https://aws.amazon.com/blogs/machine-learning/text-to-sql-solution-powered-by-amazon-bedrock/
Google Cloud. (2025). Techniques for improving text-to-SQL. https://cloud.google.com/blog/products/databases/techniques-for-improving-text-to-sql
LangChain. (2026). Build a custom SQL agent. https://docs.langchain.com/oss/python/langgraph/sql-agent
Li, J., Hui, B., Qu, G., Yang, J., Li, B., Li, B., dkk. (2023). Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs. https://arxiv.org/abs/2305.03111
Yu, T., Zhang, R., Yang, K., Yasunaga, M., Wang, D., Li, Z., dkk. (2018). Spider: A Large-Scale Human-Labeled Dataset for Complex and Cross-Domain Semantic Parsing and Text-to-SQL Task. https://arxiv.org/abs/1809.08887
Comments :