

Membaca Tagihan LLM: Input, Output, dan Token Cached
(https://www.flexera.com/blog/ai/prompt-caching-breakdown/)
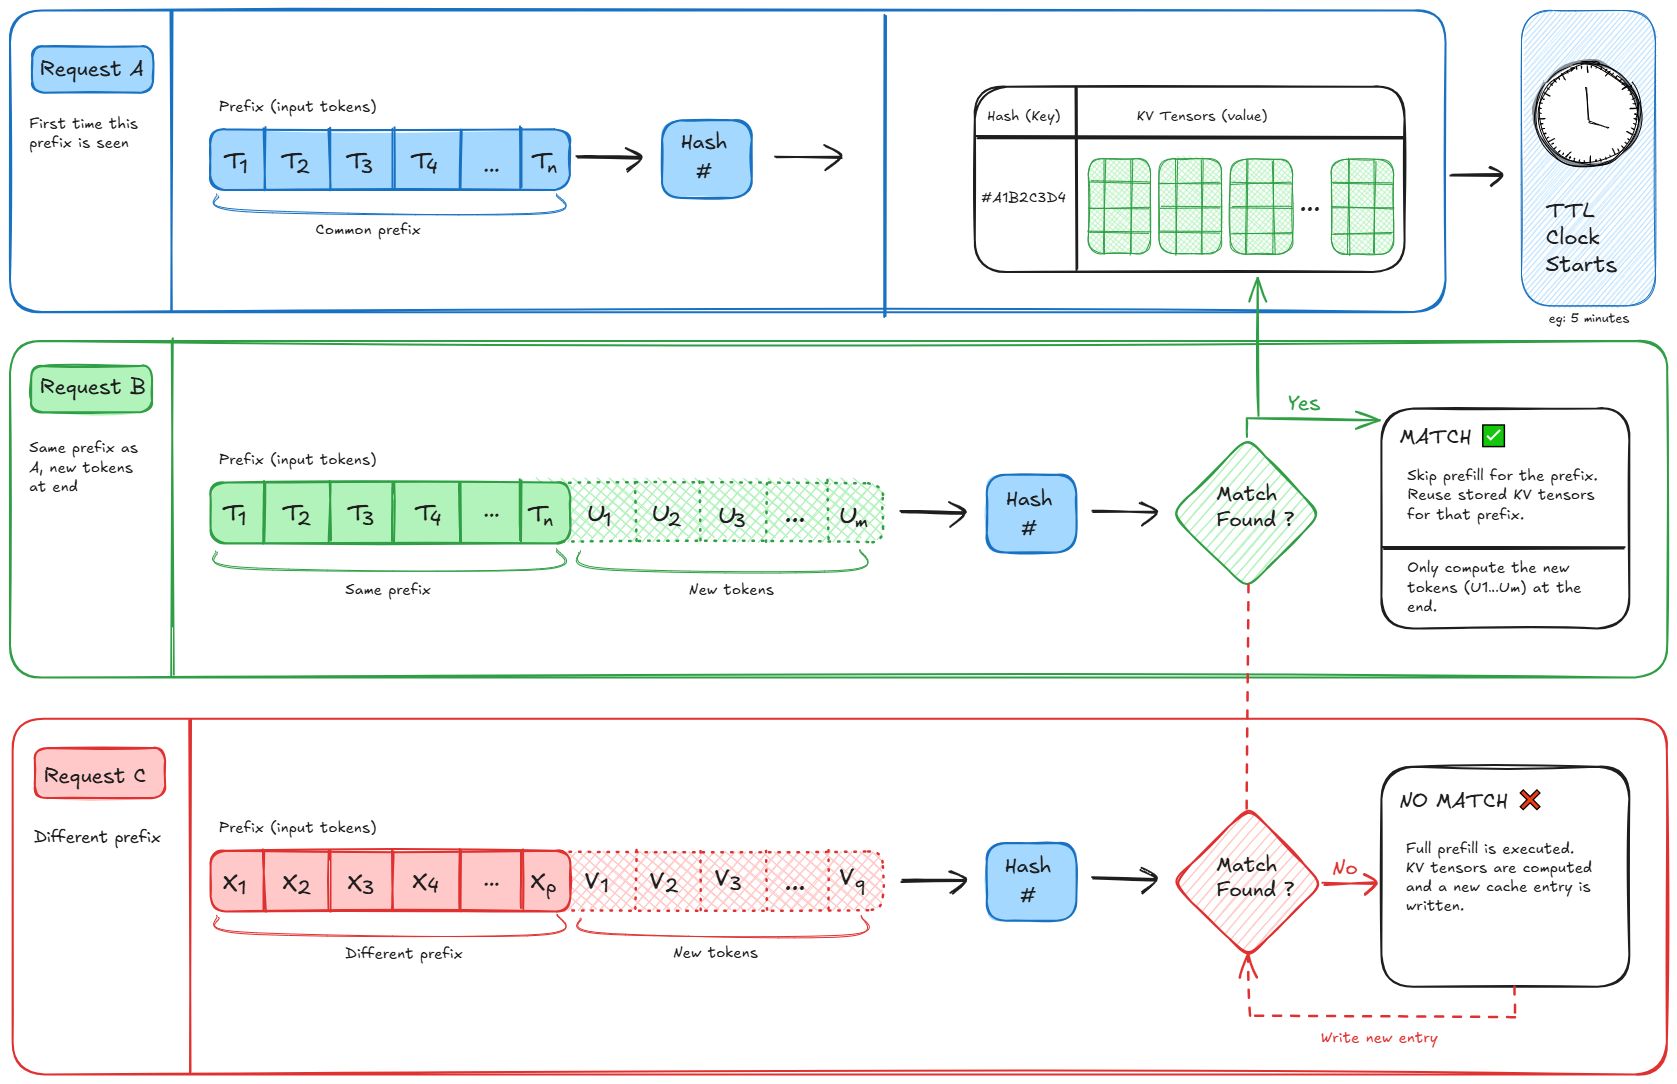
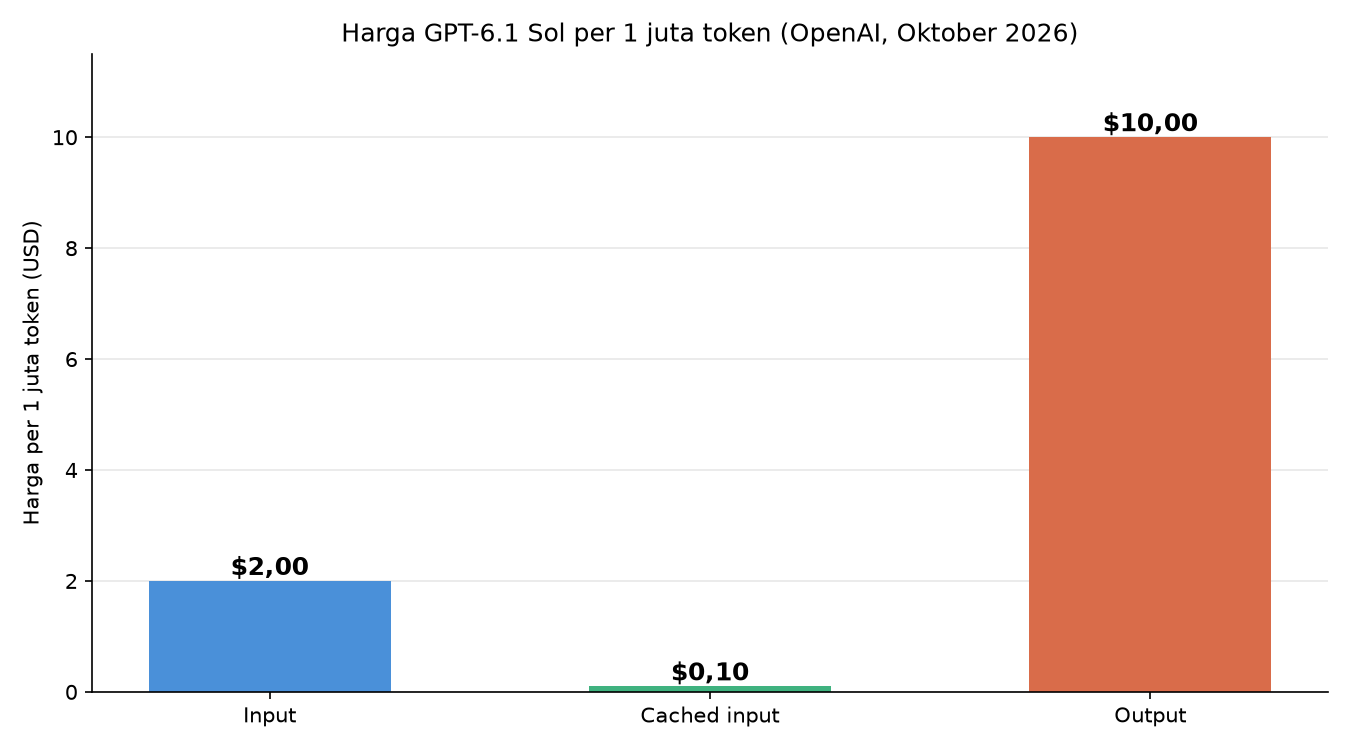
Pernahkah kamu membuka halaman pricing sebuah API LLM dan mendapati tiga angka berbeda untuk satu model yang sama? Pada GPT-6.1 Sol: input $2, cached $0,10, output $10 per juta token; cached 20 kali lebih murah. Figure 1 menjelaskan dari mana diskon itu lahir: prefix sama tidak dihitung ulang. Salah baca sedikit, tagihan membengkak. Kebiasaan membaca ketiganya menentukan tagihan bulanan chatbot atau agent kamu.
Cara Kerja Pricing per Token
API LLM mematok biaya per token, satuan potongan teks untuk membaca dan menulis, biasanya per juta token. Harga keduanya jarang sama karena kerja komputasinya beda. Token input dibaca sekaligus sehingga bisa diparalelkan di GPU. Kondisi output berbeda. Model menyusun jawaban satu token demi satu token secara autoregressive, begitu penjelasan Flexera, karena token baru bergantung pada token yang baru dibangkitkan. Satu token output berarti satu putaran penuh lewat model. Pola berantai inilah yang membuat output termahal.
Cached Input, Diskon Prefix yang Diingat Server
Cached input adalah pos termurah, kehadirannya baru sekitar 2024. OpenAI memperkenalkan prompt caching pada 1 Oktober 2024, diskon 50% untuk input token yang baru dilihat model. Anthropic melangkah lebih dulu: fitur serupa masuk Claude API 14 Agustus 2024, memangkas biaya hingga 90% dan latensi hingga 80%. Google menyediakan context caching untuk Gemini. Arahnya sama: jangan buang hasil komputasi atas teks yang sama berulang kali; selisih harganya terlihat pada Figure 2.
(https://developers.openai.com/api/docs/models/gpt-6.1-sol)
Cara kerjanya: prompt caching menyimpan prefix prompt (system prompt, dokumen, riwayat chat) di server provider. Saat permintaan berikutnya membuka prefix yang sama persis, model membaca hasil komputasinya dari cache dan kamu membayar tarif cached input. Mekanisme ini menempel pada KV cache, ingatan kerja model yang selama ini dihitung ulang tiap permintaan. Bedanya, cached input dihitung di tagihan, KV cache di VRAM. Tiga hal perlu diperhatikan:
- Harga per juta token: tagihan dinormalisasi ke satu satuan, jadi bandingkan model pada satuan yang sama.
- Diskon dan TTL berbeda: cache Anthropic hidup 5 menit dan diperbarui gratis tiap dipakai; cache OpenAI biasanya bersih setelah 5-10 menit tidak aktif.
- Biaya cache write: sebagian provider menagih penulisan cache. Anthropic mematok 1,25 kali harga input untuk TTL 5 menit, 2 kali untuk 1 jam; OpenAI memakai caching otomatis di atas 1.024 token.
Kapan Cached Input Menguntungkan?
Chatbot dengan system prompt panjang adalah kasus paling jelas. Instruksi karakter dan aturan produk yang sama dikirim ulang tiap giliran, dan di situlah cache membayar dirinya sendiri. Agent yang bertanya berkali-kali ke satu dokumen menikmati manfaat serupa karena hanya pertanyaan baru dihitung tarif penuh. Batch processing 500 kontrak berformat identik juga bisa disusun agar prefix-nya bertemu. Penyusunan prompt jadi soal desain biaya: bagian stabil di depan, bagian berubah di belakang.
Input vs Output vs Cached Input
| Aspek | Input | Cached Input | Output |
| Fungsi dalam tagihan | Dikirim ke model | Dibaca ulang dari cache | Dibangkitkan model |
| Arah komputasi | Dibaca paralel sekaligus | Tanpa komputasi ulang | Satu token per putaran |
| Harga relatif | Patokan dasar | Termurah, 5-10% dari harga input | Termahal, 4-10x harga input |
| Contoh GPT-6.1 Sol | $2 per juta token | $0,10 per juta token (5% harga input) | $10 per juta token |
| Contoh Claude Sonnet 5.5 | $2 per juta token | $0,10 per juta token (cache read) | $10 per juta token |
| Contoh Gemini 3.8 Flash | $0,75 per juta token | $0,075 per juta token (context caching) | $3,75 per juta token |
| Kasus optimal | Konten baru tiap kali | Prefix besar yang dipakai ulang | Jawaban pendek |
Kelebihan dan Keterbatasan Prompt Caching
Efisiensi biayanya nyata untuk aplikasi yang prefix-nya stabil, dan latensi ikut turun. Keterbatasannya, prefix harus sama persis; satu karakter berubah, cache hangus dan tagihan kembali penuh. Cache punya TTL, sehingga aplikasi dengan trafik jarang menikmati hit. Di Anthropic kamu membayar cache write di muka; prefix kecil yang dipakai sekali bisa lebih mahal. Diskon juga bukan janji permanen; harga provider berubah, catat tanggal ceknya.
Kesimpulan
Tiga angka itu menggambarkan tiga jenis kerja: membaca sekaligus, membaca ulang, dan menulis token demi token. Cache mengubah cara menyusun prompt karena struktur rapi berarti tagihan lebih kecil. Kombinasinya membuat aplikasi padat konten berulang jauh lebih murah daripada angka di tabel. Kebiasaan membaca pricing page tiga kolom ini kelak jadi skill dasar pengembang AI. Sebelum menghubungkan kartu kredit, buka pricing page providermu dan hitung lewat kalkulator token resmi.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
OpenAI. (2024). Prompt Caching in the API. https://openai.com/index/api-prompt-caching/
Anthropic. (2024). Claude Platform Release Notes. https://platform.claude.com/docs/en/release-notes/overview
Anthropic. (2026). Prompt Caching. https://platform.claude.com/docs/en/build-with-claude/prompt-caching
Flexera. (2026). Prompt Caching Breakdown: How It Reduces Token Spend. https://www.flexera.com/blog/ai/prompt-caching-breakdown/
OpenAI. (2026). GPT-6.1 Sol Model. https://developers.openai.com/api/docs/models/gpt-6.1-sol
OpenAI. (2026). Pricing | OpenAI API. https://developers.openai.com/api/docs/pricing
Google. (2026). Gemini Developer API Pricing. https://ai.google.dev/gemini-api/docs/pricing
Comments :