

KV Cache Eviction: Memilih Ingatan yang Dibuang LLM
(https://arxiv.org/abs/2309.17453)
Pernahkah kamu meninggalkan asisten AI memproses konteks ratusan ribu token, lalu sesinya macet di tengah jalan? Penyebabnya ada di ingatan kerja model yang disebut KV cache: catatan per token membesar tanpa henti di VRAM GPU terbatas. Sistem inference harus memilih ingatan yang dibuang. Pilihan itu diatur eviction policy. Empat kebijakan berikut paling sering dijumpai di riset dan produksi.
Apa Itu KV Cache dan Mengapa Tumbuh Terus?
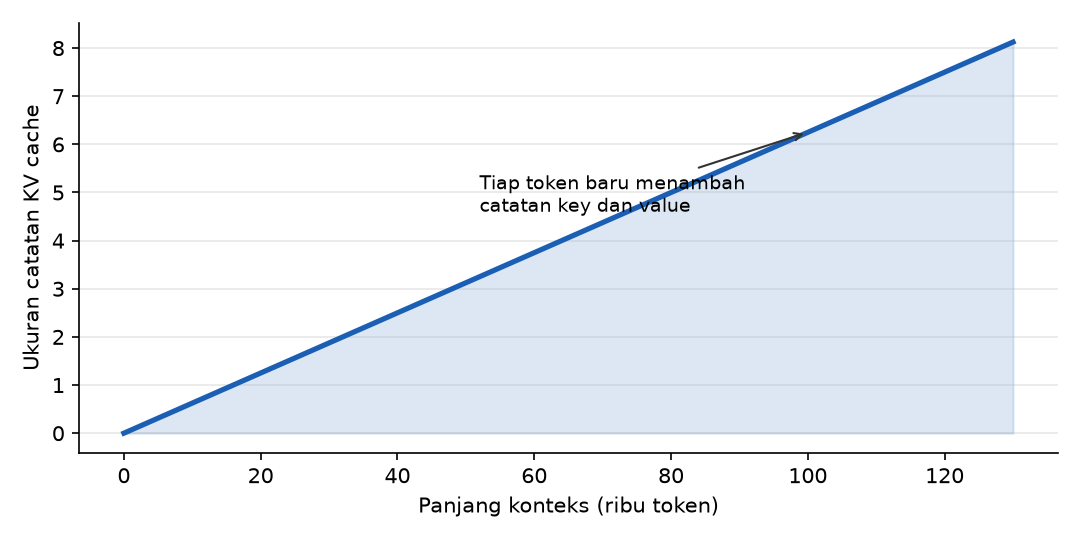
Setiap token di model Transformer menghasilkan sepasang vektor, key dan value, bahan utama perhitungan attention. KV cache menyimpan pasangan itu supaya token lama tidak dihitung ulang saat token baru lahir, persis pola yang digambarkan pada Figure 1. Catatannya bertambah satu baris per token. Ukurannya tumbuh linier mengikuti panjang sekuens. Tim vLLM menghitung cache satu sekuens di LLaMA-13B bisa menempati sampai 1,7 GB, pertumbuhan yang dilukis pada Figure 2.
(https://blog.vllm.ai/2023/06/20/vllm.html)
Karena VRAM terbatas, pengelolaan cache jadi disiplin tersendiri. Titik baliknya pada 2023, ketika tim vLLM dari UC Berkeley memperkenalkan PagedAttention di konferensi SOSP 2023. Algoritma ini membagi cache menjadi blok kecil seperti virtual memory, dan memori terbuang turun ke bawah 4 persen. Tekniknya menyelesaikan penempatan cache; mana isi yang layak disimpan tetap terbuka. Sejak saat itu, cara membuang isi cache jadi perhatian riset yang sengit.
Empat Kebijakan Eviction KV Cache
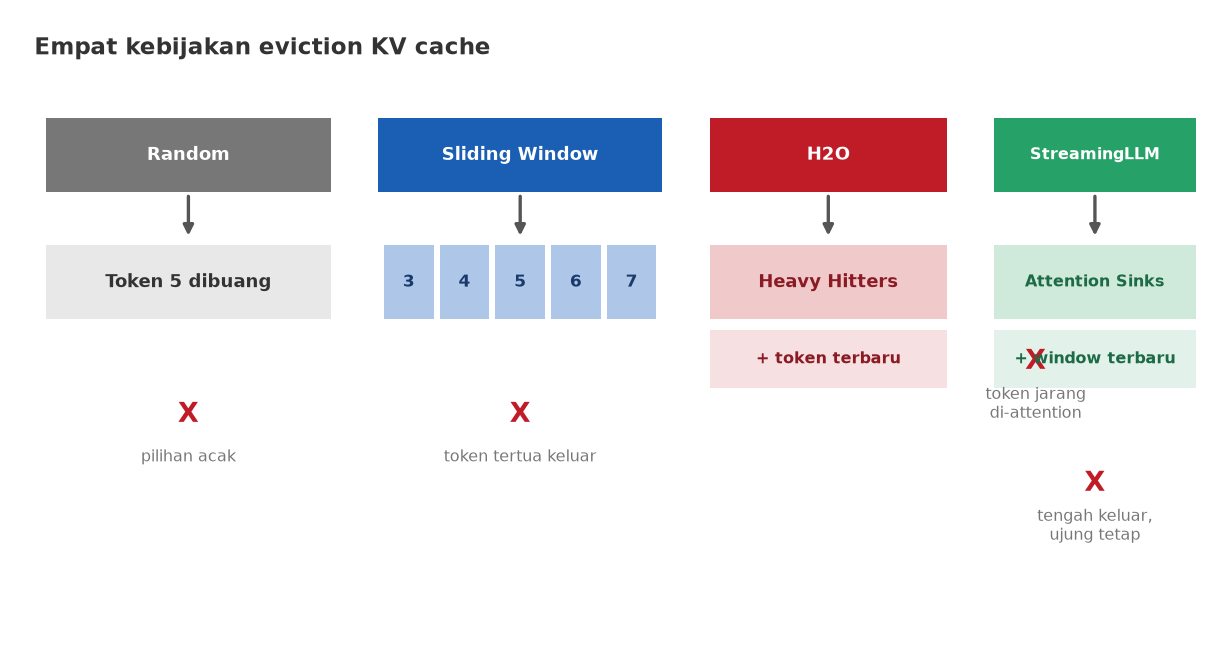
Saat cache penuh, sistem menjalankan eviction policy, aturan pemilih token yang dicoret. Aturan ini menentukan langsung apakah jawaban tetap koheren atau mulai kehilangan benang merahnya. Empat pendekatan populer berkembang dari riset 2023, perbandingannya ada pada Figure 3. Bedanya terletak pada cara menilai pentingnya token. Spektrumnya lebar, dari acak murni sampai membaca pola attention.
- Random: token dibuang acak. Termurah, tetapi tanpa dasar menilai kepentingan token yang hilang.
- Sliding window: cache hanya menyimpan token paling baru; token tertua keluar duluan. Memori terkendali, meski konteks yang lewat hilang.
- H2O: Heavy Hitter Oracle, riset NeurIPS 2023, memanfaatkan temuan bahwa sebagian kecil token menyumbang sebagian besar nilai attention. Kebijakan ini mempertahankan heavy hitters (token yang paling sering menerima attention) plus token terbaru.
- Attention sinks: StreamingLLM menunjukkan bahwa token awal berfungsi sebagai attention sink, tempat model menumpuk sisa skor attention meski isinya tak bermakna. Menyimpan KV token awal bersama jendela token terbaru menjaga model stabil.
(https://arxiv.org/abs/2306.14048)
Contoh Penggunaan di Dunia Nyata
Di aplikasi streaming, StreamingLLM menjaga Llama-2, MPT, Falcon, dan Pythia memproses teks sampai 4 juta token tanpa pelatihan ulang, secepat 22,2 kali baseline yang menghitung ulang cache tiap langkah. H2O mengisi cache dengan 20 persen heavy hitters: throughput naik sampai 29 kali pada OPT-6.7B dan OPT-30B. Di produksi, vLLM dengan PagedAttention menaikkan throughput LLM populer 2 sampai 4 kali pada latensi setara. LMSYS memakainya untuk Chatbot Arena: rata-rata 30 ribu request per hari, puncaknya 60 ribu. Angka ini menunjukkan eviction berdampak ke biaya server, bukan sekadar catatan kaki riset.
Perbandingan Empat Kebijakan
| Aspek | Random | Sliding Window | H2O | Attention Sinks |
| Token yang dibuang | Acak | Tertua duluan | Yang jarang di-attention | Token tengah |
| Yang dipertahankan | Tanpa pola | Token terbaru | Heavy hitters dan token terbaru | Token awal dan terbaru |
| Kekuatan | Sederhana | Memori tetap di konteks panjang | Akurasi terjaga dengan cache kecil | Streaming stabil tanpa fine-tuning |
| Risiko kualitas | Penting bisa terbuang | Konteks lama hilang | Skor attention bergeser | Perhatian melebar bila sink hilang |
| Cocok untuk | Eksperimen cepat | Chat konteks pendek | Serving hemat memori | Asisten yang berjalan terus |
Keterbatasan yang Perlu Diwaspadai
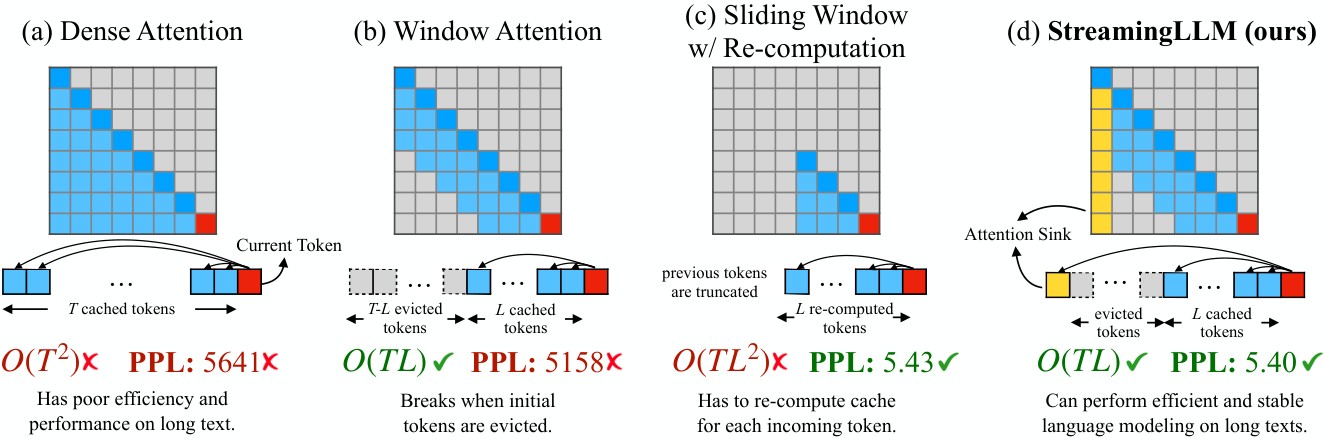
Salah membuang token langsung merusak jawaban. Paper StreamingLLM mengukurnya di Llama-2-13B: window attention yang membuang token awal membuat perplexity melonjak ke 5158,07 pada teks PG19; menyimpan empat token awal menahannya di 5,40. Trade-off memori dan akurasi tak bisa dihindari, hanya dikendalikan. Cache yang dipangkas agresif lebih murah, tetapi peluang menghapus informasi penting ikut naik. Policy yang unggul di satu jenis teks belum tentu unggul di jenis lain, jadi uji dengan data kamu sebelum produksi.
Kesimpulan
KV cache eviction memberi LLM kemampuan melupakan secara terpilih, sehingga konteks panjang tidak berarti tagihan VRAM yang memberat. Arah pengembangannya menuju policy yang makin cermat menimbang token layak simpan. Riset 2023 sampai 2024 menunjukkan cache bisa dipangkas besar tanpa menghancurkan kualitas. Langkah praktisnya: cocokkan policy dengan pola pemakaian aplikasimu, lalu ukur kualitas jawaban di data sendiri. Bagi kamu yang membangun aplikasi LLM, kebijakan ini layak dipikirkan sejak desain awal, sebelum GPU kehabisan napas.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Zhang, Z., dkk. (2023). H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models. https://arxiv.org/abs/2306.14048
Xiao, G., dkk. (2023). Efficient Streaming Language Models with Attention Sinks. https://arxiv.org/abs/2309.17453
Kwon, W., dkk. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. https://arxiv.org/abs/2309.06180
vLLM Team. (2023). vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention. https://blog.vllm.ai/2023/06/20/vllm.html
Comments :