

Contextual Retrieval: Saat RAG Kehilangan Makna di Tengah Jalan
(https://www.anthropic.com/news/contextual-retrieval)
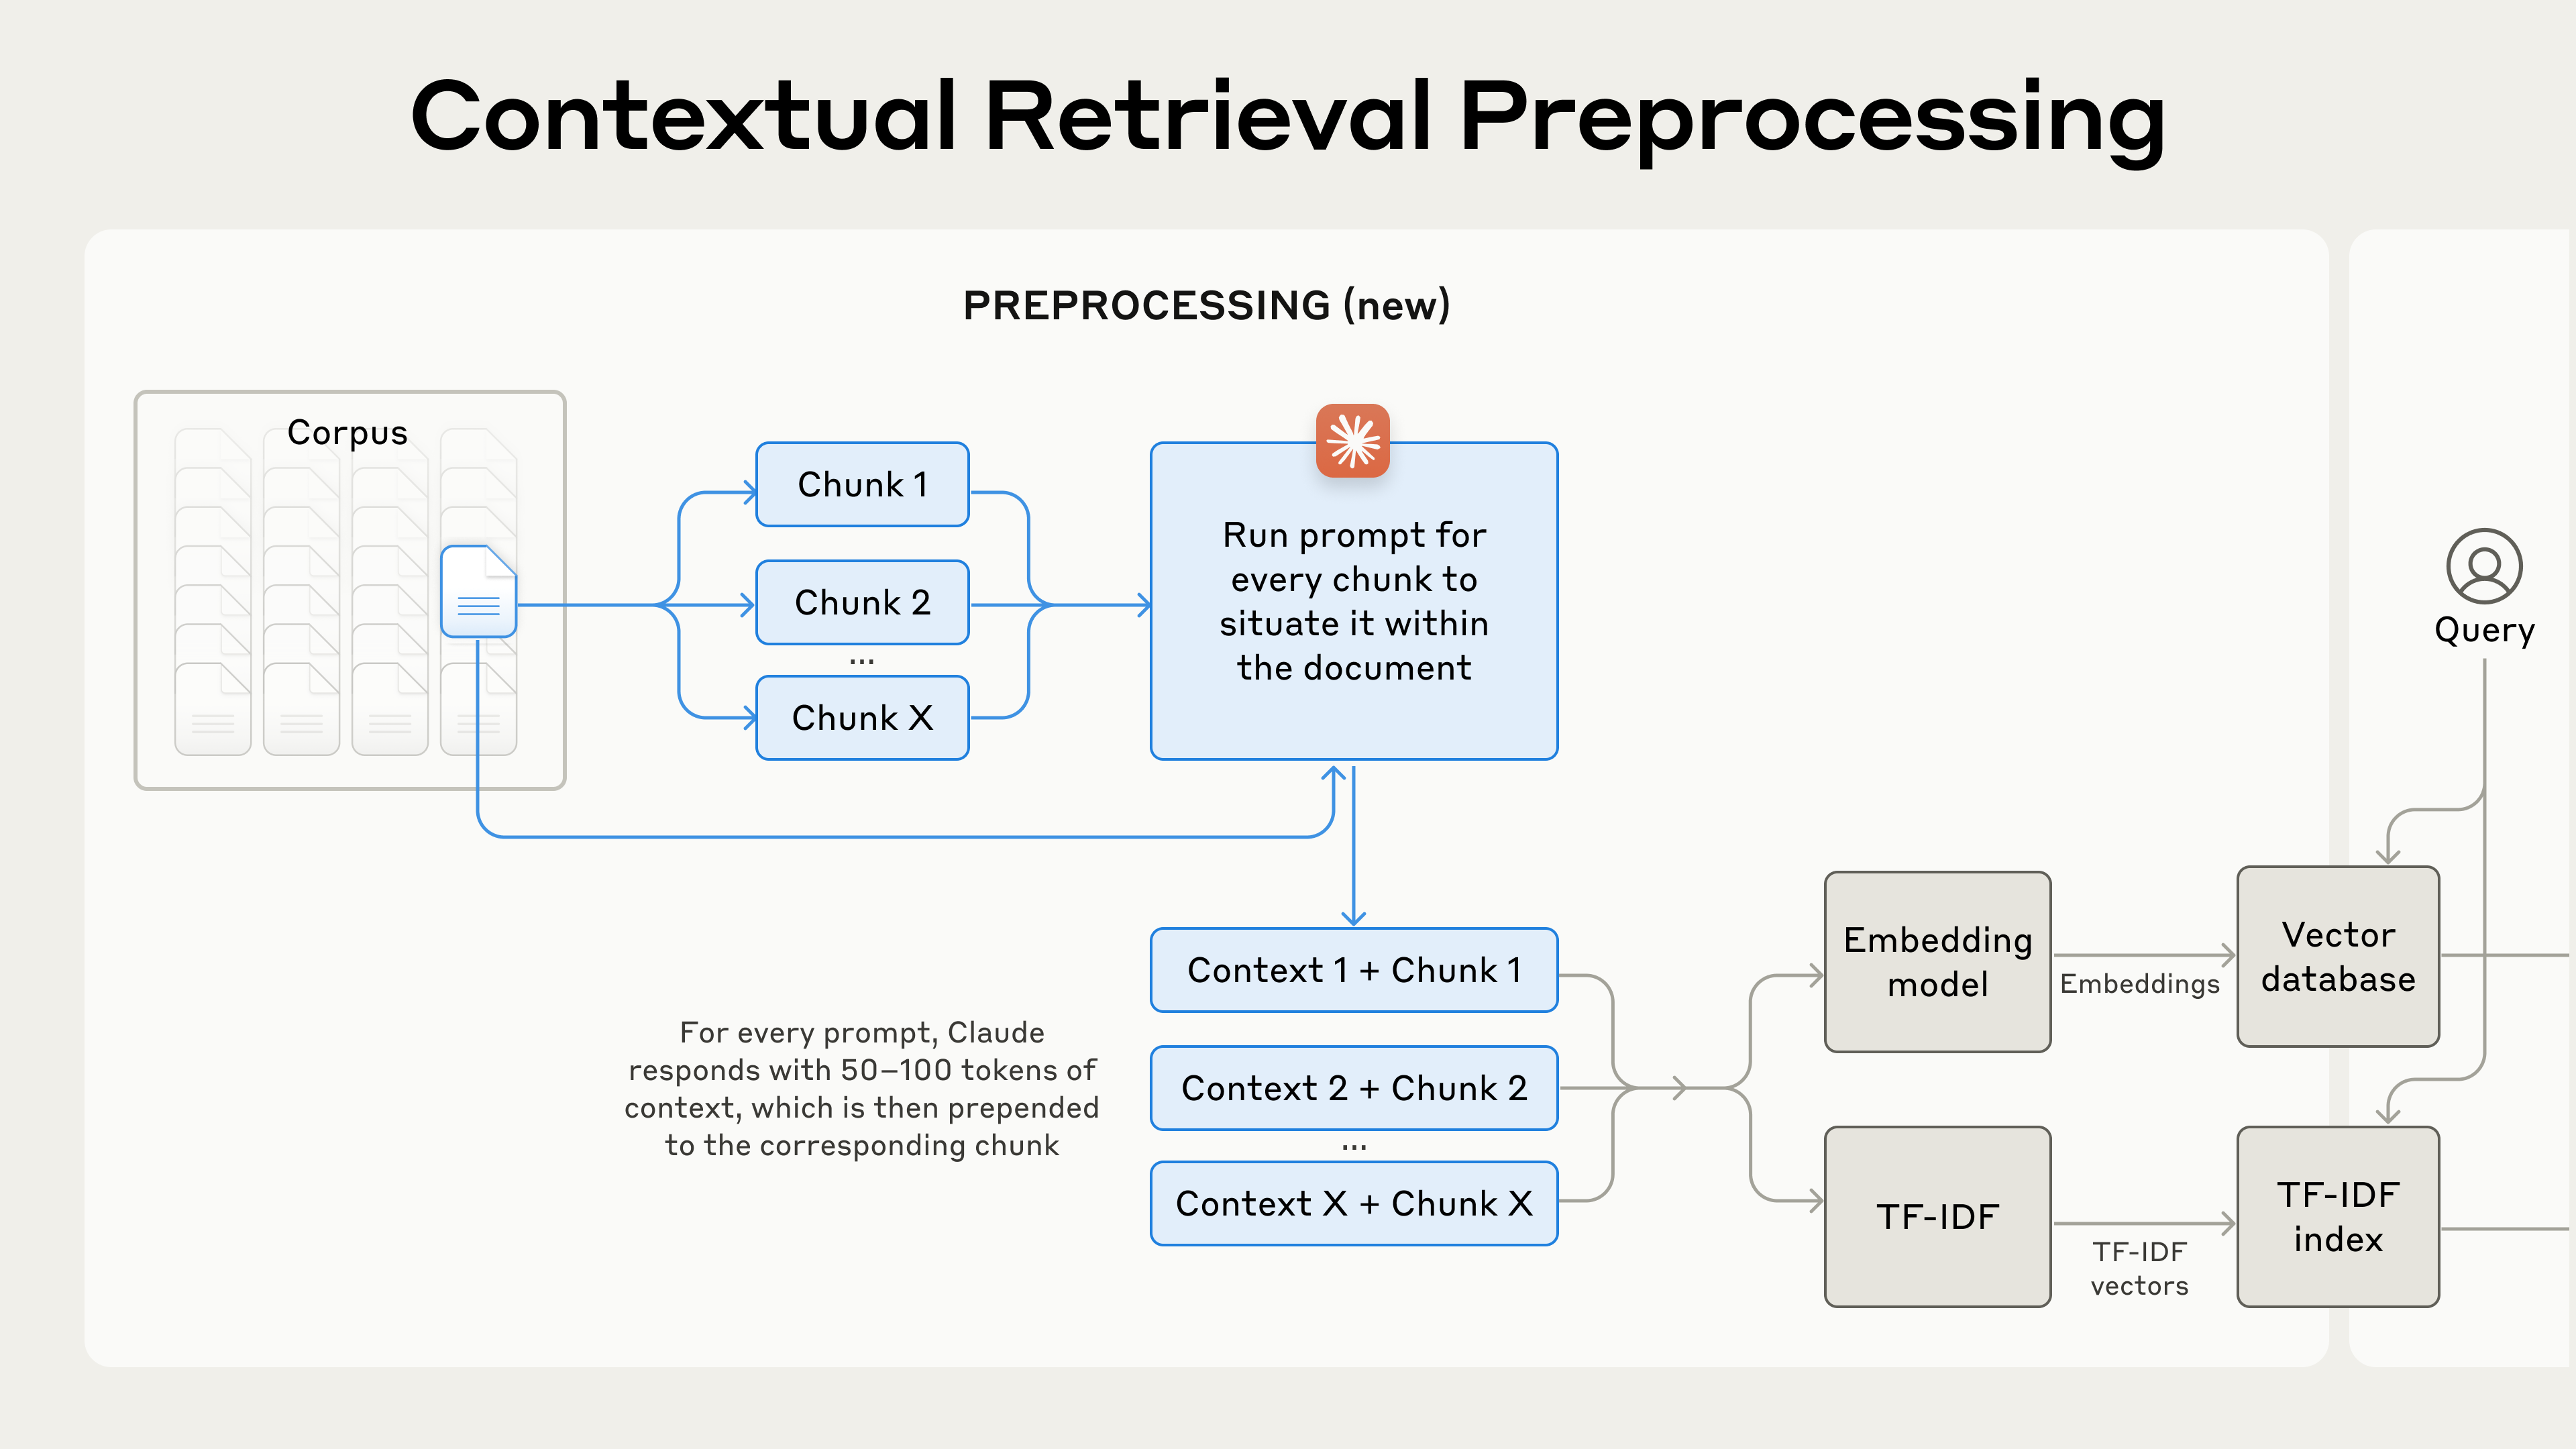
Pernahkah kamu bertanya ke chatbot dokumen kampus dan jawabannya meleset, padahal informasinya ada di salah satu halaman? Penyebabnya sering di tahap pencarian: sistem gagal menemukan potongan yang tepat. Bayangkan sebuah chunk (potongan teks hasil pemecahan dokumen) berisi kalimat “ia dinyatakan lulus uji kompetensi.” Siapa “ia”? Berdiri sendiri, fragmen ini kehilangan subjek dan latar, sehingga mesin pencari sulit mencocokkannya dengan pertanyaanmu, persis masalah yang coba dijawab alur pada Figure 1.
Apa Itu Contextual Retrieval?
Contextual Retrieval adalah teknik pra-pemrosesan untuk RAG (Retrieval-Augmented Generation), metode penggabungan model bahasa dengan pencarian dokumen. Patrick Lewis dan timnya memperkenalkan RAG pada 2020. Alurnya: dokumen dipecah menjadi chunk beberapa ratus token, diubah menjadi embedding (representasi vektor makna), lalu potongan terbaik disodorkan ke model. Kelemahan itu menetap di langkah pemecahan: chunk yang terpisah dari halaman asalnya kehilangan makna. Tim Anthropic menjawabnya lewat Contextual Retrieval pada September 2024: sebelum chunk diindeks, LLM menulis deskripsi singkat yang mengaitkannya dengan isi keseluruhan dokumen, biasanya 50-100 token, lalu ditempel di depan chunk.
Cara Kerja: Konteks Ditempel Sebelum Diindeks
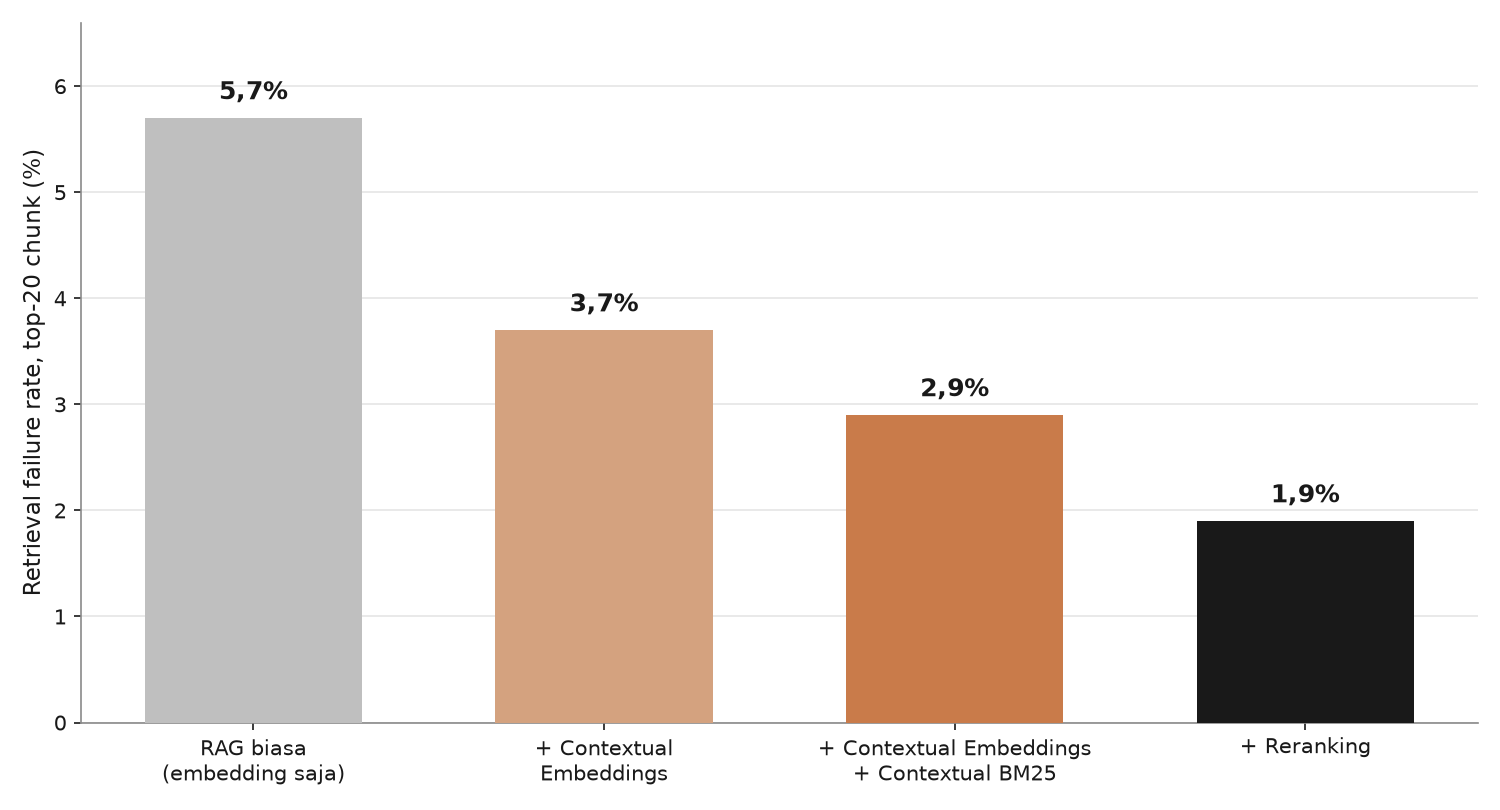
Keempat komponen berikut saling menopang, dan efek gabungannya terlihat pada Figure 2:
- Contextual embeddings: chunk yang sudah diberi konteks diubah menjadi vektor makna, sehingga pencarian semantik tidak menebak arti fragmen terputus.
- Contextual BM25: index kata kunci dibuat dari chunk yang sama, menangkap kecocokan persis seperti kode error.
- Hybrid search: hasil keduanya digabung, karena embedding bisa meleset pada istilah unik dan BM25 kaku pada parafrase.
- Reranking: model reranker membaca query beserta kandidat lalu mengurutkan ulang; Anthropic memakai reranker Cohere dan menyaring 150 kandidat menjadi 20 teratas.
(https://www.anthropic.com/news/contextual-retrieval)
Contoh Penerapan di Dunia Nyata
Kasus pertama datang dari helpdesk teknis. Pengguna mengetik “Error code TS-999”; embedding semantik cenderung menemukan halaman soal kode error secara umum, sementara BM25 menangkap string TS-999 secara persis. Contoh dari blog Anthropic sendiri: potongan laporan berisi “pendapatan perusahaan tumbuh 3% dari kuartal sebelumnya.” Setelah diproses, chunk itu terbaca sebagai bagian laporan SEC ACME Corp kuartal II 2023, lengkap dengan pendapatan kuartal sebelumnya. Kondisi serupa terjadi pada chatbot regulasi akademik. Potongan “mahasiswa dinyatakan lulus yudisium” jadi terlacak karena konteksnya menyebut nama fakultas dan tahun akademik dokumen asal. Pola yang sama membantu pencarian di codebase, tempat kalimat “fungsi ini tidak lagi dipakai” baru bermakna jika versi dan modulnya ikut disebut.
RAG Biasa vs Contextual Retrieval
Perbedaan keduanya bisa diringkas dalam satu tabel:
| Aspek | RAG Biasa | Contextual Retrieval |
| Konteks chunk | Hilang saat dokumen dipecah | Ditulis LLM, ditempel di depan tiap chunk |
| Index semantik | Embedding biasa | Contextual embeddings |
| Index kata kunci | BM25 tanpa konteks | Contextual BM25 |
| Failure rate top-20 | 5,7% (embedding saja) | 3,7% dengan contextual embeddings; 2,9% dengan contextual BM25 |
| Dengan reranking | 5,7% | 1,9%, turun 67% dari baseline |
| Biaya indexing | Rendah, tanpa panggilan LLM | Lebih mahal, ada langkah LLM per chunk |
Kelebihan dan Keterbatasan
- Akurasi naik terukur: uji Anthropic mencatat penurunan failure rate 35% dengan contextual embeddings dan 49% setelah contextual BM25 ditambahkan; dengan reranking, totalnya 67%.
- Indexing lebih mahal: tiap chunk butuh panggilan LLM saat pembuatan index, sehingga korpus besar menanggung biaya dan waktu ekstra.
- Biayanya bisa ditahan: dengan prompt caching, dokumen cukup dimuat sekali ke cache; Anthropic menghitung biayanya sekitar 1,02 dollar AS per juta token dokumen, dan prompt caching menekan biaya hingga 90% serta latensi hingga 85% pada prompt panjang.
- Latensi runtime bertambah: reranking menambah satu langkah saat pengguna menunggu jawaban, meski kandidat dinilai paralel.
Kesimpulan
Contextual Retrieval tidak mengubah arsitektur RAG; ia merapikan bahan bacaannya sebelum model membaca. Penurunan failure rate dari 5,7% ke 1,9% adalah perbaikan yang bisa dihitung. Prompt caching membuat biaya indexing-nya masuk akal. Riset berikutnya kemungkinan menuju penulisan konteks yang lebih murah dan otomatis. Kalau kamu membangun chatbot dokumen, langkah pertamanya sederhana: pastikan setiap chunk tahu siapa “ia”.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Anthropic. (2024). Introducing Contextual Retrieval. https://www.anthropic.com/news/contextual-retrieval
Lewis, P., dkk. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. https://arxiv.org/abs/2005.11401
Anthropic. (2025). Prompt Caching with Claude. https://claude.com/resources/articles/prompt-caching
Cohere. (2026). Introducing Rerank 5: Precise, Efficient Enterprise Document Retrieval. https://cohere.com/blog/rerank-5
Cohere. (2026). An Overview of Cohere’s Rerank Model. https://docs.cohere.com/docs/rerank-overview
Comments :