

AI Musik Generatif: Dari Teks Menjadi Lagu Jadi
(https://cdn-o.suno.com/meta-preview.jpg)
Pernahkah kamu mengetik satu kalimat lalu menerima lagu lengkap beberapa detik kemudian. Catat sejak awal bahwa topiknya adalah komposisi musik dari teks, seperti pada Figure 1, dan kita akan membandingkan dua paradigma pembangkitan industri. Layanan seperti Suno dan Udio mengubah deskripsi teks menjadi lagu jadi lewat model yang dibahas artikel ini. Pembahasannya murni sisi teknologi dari sudut pandang ilmu komputer. Kamu akan melihat mengapa pendekatan token dan difusi menghasilkan karakter lagu berbeda.
Kamu perlu memisahkan topik ini dari teknologi tetangga yang sering tercampur. Speech synthesis dan voice cloning meniru suara manusia, sedangkan model di sini menciptakan melodi dan aransemen dari nol. Sistem rekomendasi mood hanya memilih lagu yang sudah ada dari katalog, sedangkan model di sini menciptakan rekaman baru. Praktik live-coding seperti Tidal Cycles menulis musik lewat kode yang dieksekusi langsung, sedangkan AI musik generatif memprediksi bunyi lewat model yang dilatih dari data. Empat batasan ini penting agar kamu tidak salah menilai kemampuan maupun risiko teknologinya.
Apa Itu AI Musik Generatif?
AI musik generatif adalah sistem yang mengubah perintah teks menjadi rekaman musik baru. Peneliti Google memperkenalkan AudioLM pada 2022 sebagai kerangka yang memetakan audio ke token diskret. Tim yang sama merilis MusicLM pada Januari 2023 yang menghasilkan musik 24 kHz yang konsisten selama beberapa menit. Meta merilis MusicGen pada 2023 sebagai model bahasa satu tahap di atas token musik terkompresi. Stability AI merilis Stable Audio Open pada 2024 sebagai model difusi laten terbuka, dan Suno serta Udio menjadi bukti industri kedua paradigma tersebut.
Cara Kerja Tokenisasi Audio dan Conditioning Teks
Model musik tidak memprediksi gelombang mentah karena urutannya terlalu panjang. Peneliti mengompresi audio menjadi representasi padat lalu memodelkannya secara generatif lewat tiga komponen berikut:
- tokenisasi audio: encoder saraf seperti EnCodec mengubah gelombang menjadi token diskret
- conditioning teks: encoder seperti T5 atau CLAP mengubah perintah menjadi vektor konteks
- decoder: transformer memprediksi token berikutnya lalu membangun kembali gelombang stereo
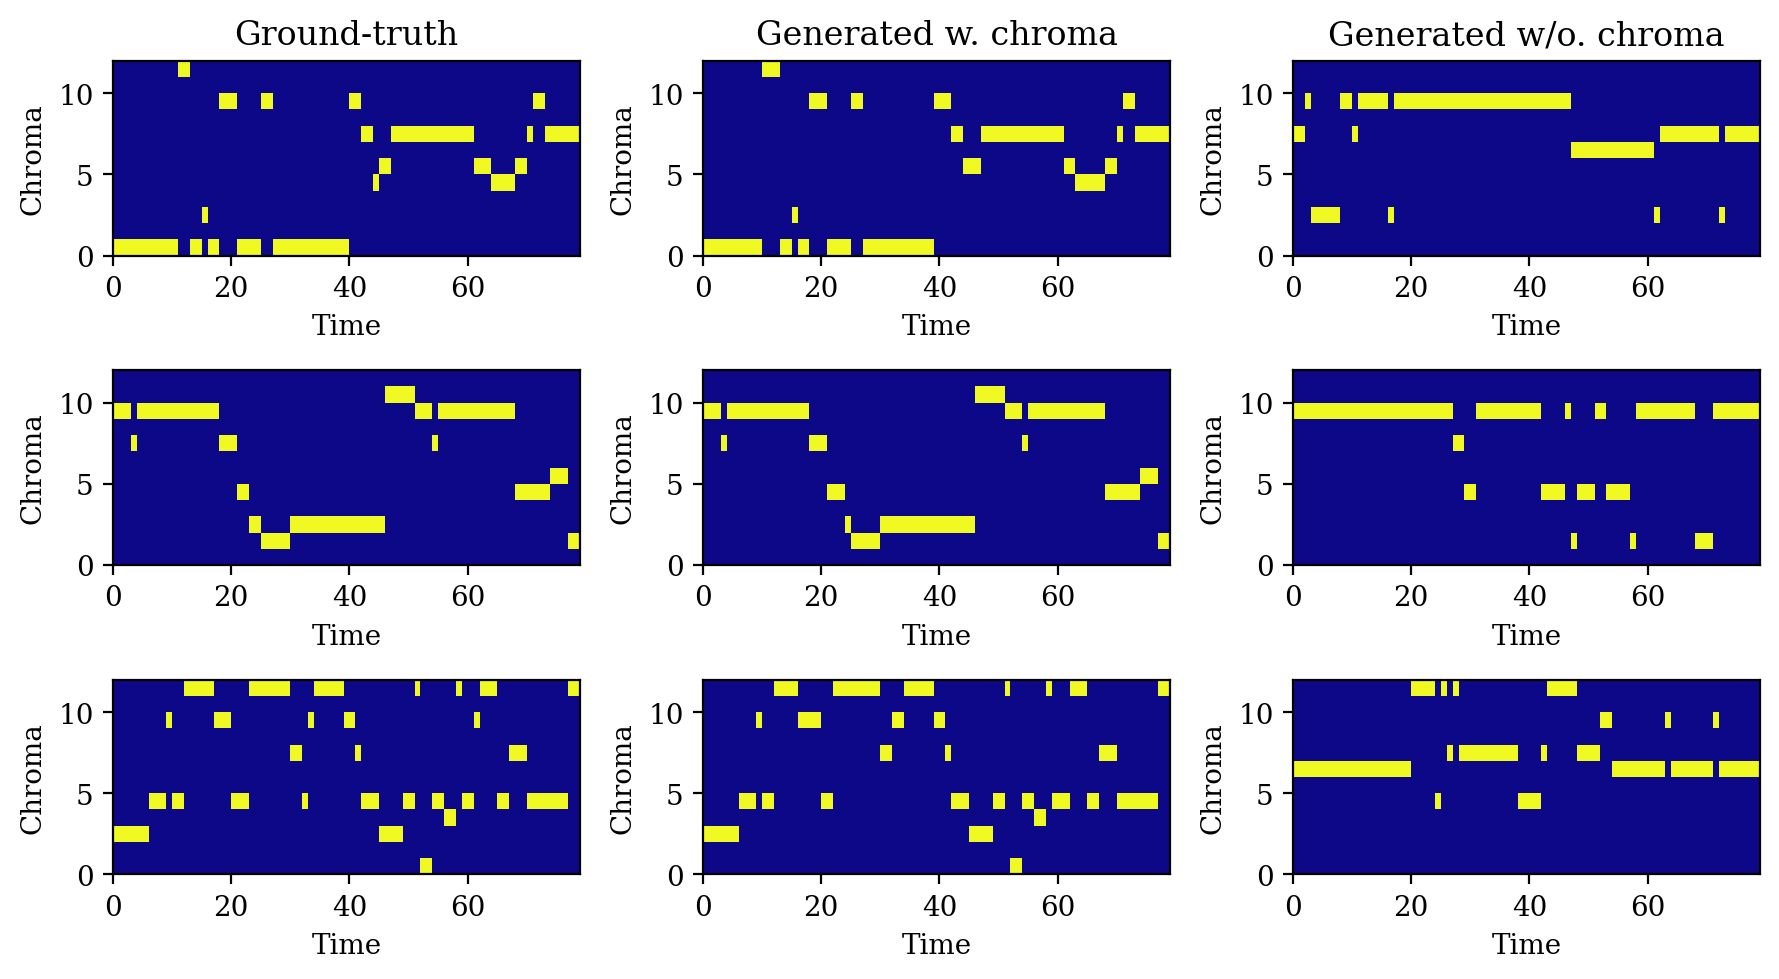
MusicGen memakai 4 quantizer berukuran 2048 dengan pola tunda sehingga 30 detik audio menjadi 1500 langkah. MusicLM memakai token semantik kasar untuk struktur lagu lalu token akustik halus untuk detail bunyi. Stable Audio Open memakai autoencoder variasional untuk memadatkan gelombang lalu difusi bekerja di ruang laten. Visualisasi pada Figure 2 menunjukkan conditioning melodi menjaga struktur lagu ketika teks saja tidak cukup. Tiga mekanisme ini menjelaskan mengapa satu kalimat perintah bisa menjadi musik yang koheren.
(https://arxiv.org/html/2306.05284v1/figs/chroma.png)

Contoh Penggunaan di Dunia Nyata
Kreator konten mengetik suasana seperti pop akustik ceria lalu memakai hasilnya sebagai latar video. Musisi bersenandung lalu meminta model mengaransemen ulang dalam gaya rock, seperti mekanisme pada Figure 2. Peneliti memakai MusicGen yang terbuka untuk bereksperimen dengan encoder T5 atau CLAP pada MusicCaps berisi 5.500 pasangan musik-teks. Komunitas open source memakai Stable Audio Open yang menghasilkan audio stereo sampai 47 detik untuk efek suara. Tim MusicGen melaporkan penilai manusia memberi skor 84,8 dari 100 untuk MusicGen melawan 80,5 untuk MusicLM.
Perbandingan Singkat
Tabel berikut merangkum perbedaan kedua pendekatan:
| Aspek | Model Bahasa Token Audio | Difusi Laten |
| Representasi | Token diskret codec saraf | Laten kontinu autoencoder |
| Model inti | Transformer autoregresif | Transformer difusi laten |
| Conditioning | T5 dan CLAP | Encoder T5 |
| Keluaran | Stereo 32 kHz | Stereo 44,1 kHz 47 detik |
| Contoh | MusicGen, MusicLM | Stable Audio, Suno, Udio |
Kelebihan dan Keterbatasan
Kelebihan pertama adalah keterbukaan riset karena MusicGen dan Stable Audio Open merilis kode dan bobot. Kelebihan kedua adalah kendali ganda lewat teks dan melodi sehingga kamu menentukan gaya sekaligus struktur. Keterbatasan pertama adalah struktur lagu panjang yang lemah karena model sering mengulang pola. Keterbatasan kedua adalah vokal yang tidak stabil karena suku kata bisa melebur pada aransemen padat. Keterbatasan ketiga adalah sengketa data latih karena MusicGen memakai 20 ribu jam musik berlisensi sedangkan Stable Audio Open memakai rekaman Creative Commons. Kamu perlu membaca ketentuan lisensi tiap layanan sebelum memakai lagu hasilnya secara komersial.
Kesimpulan
AI musik generatif mengubah perintah teks menjadi lagu lewat model bahasa di atas token diskret atau difusi laten di atas representasi kontinu. Tokenisasi audio menekan panjang urutan lewat codec saraf dan conditioning teks memberi kendali gaya. Skor penilaian manusia 84,8 melawan 80,5 menunjukkan kemajuan walau struktur panjang dan vokal tetap menjadi pekerjaan rumah. Pilihan data latih berlisensi atau Creative Commons ikut menentukan ragam musik yang keluar. Coba jalankan demo terbuka MusicGen atau Stable Audio Open, dengarkan hasilnya dengan telinga kritis, lalu putuskan sendiri kapan teknologi ini membantu proses kreatif kamu.
Penulis: Emmanuel Daniel Widhiarto, S.Kom – FDP Scholar
Referensi
Copet dkk. (2023). Simple and Controllable Music Generation. https://arxiv.org/abs/2306.05284
Agostinelli dkk. (2023). MusicLM: Generating Music From Text. https://arxiv.org/abs/2301.11325
Borsos dkk. (2022). AudioLM: a Language Modeling Approach to Audio Generation. https://arxiv.org/abs/2209.03143
Evans dkk. (2024). Stable Audio Open. https://arxiv.org/abs/2407.14358
Suno. (2026). Suno | AI Music Generator. https://suno.com/
Comments :